预约页面可以提交、通知也能送达,下一步要问的是:在多少请求下,用户等多久,系统能持续完成多少工作?把 CPU 主频、登录人数和响应时间并列写成“性能高”,还不能回答这个问题。它们观察不同对象,时间口径也不同。本节先确定测什么,再用完整条件算;随后看局部优化怎样影响整体,以及一次测试究竟支持什么结论。文中的预约服务与数值变式是教学场景,不是实测业务成绩。
2.9.1 性能指标:先说出测量对象
用户从预约页面看见的是一次请求的体验,路由器看到转发的分组,操作系统看到可运行任务和资源,数据库看到事务。它们会同时参与同一次访问。若网络丢包使页面变慢,页面响应延迟仍是应用端的观察,丢包率仍按网络分组口径测。指标归属回答“在哪个对象上测”,瓶颈排查回答“什么因素造成这个结果”。两种问题可以跨层关联。
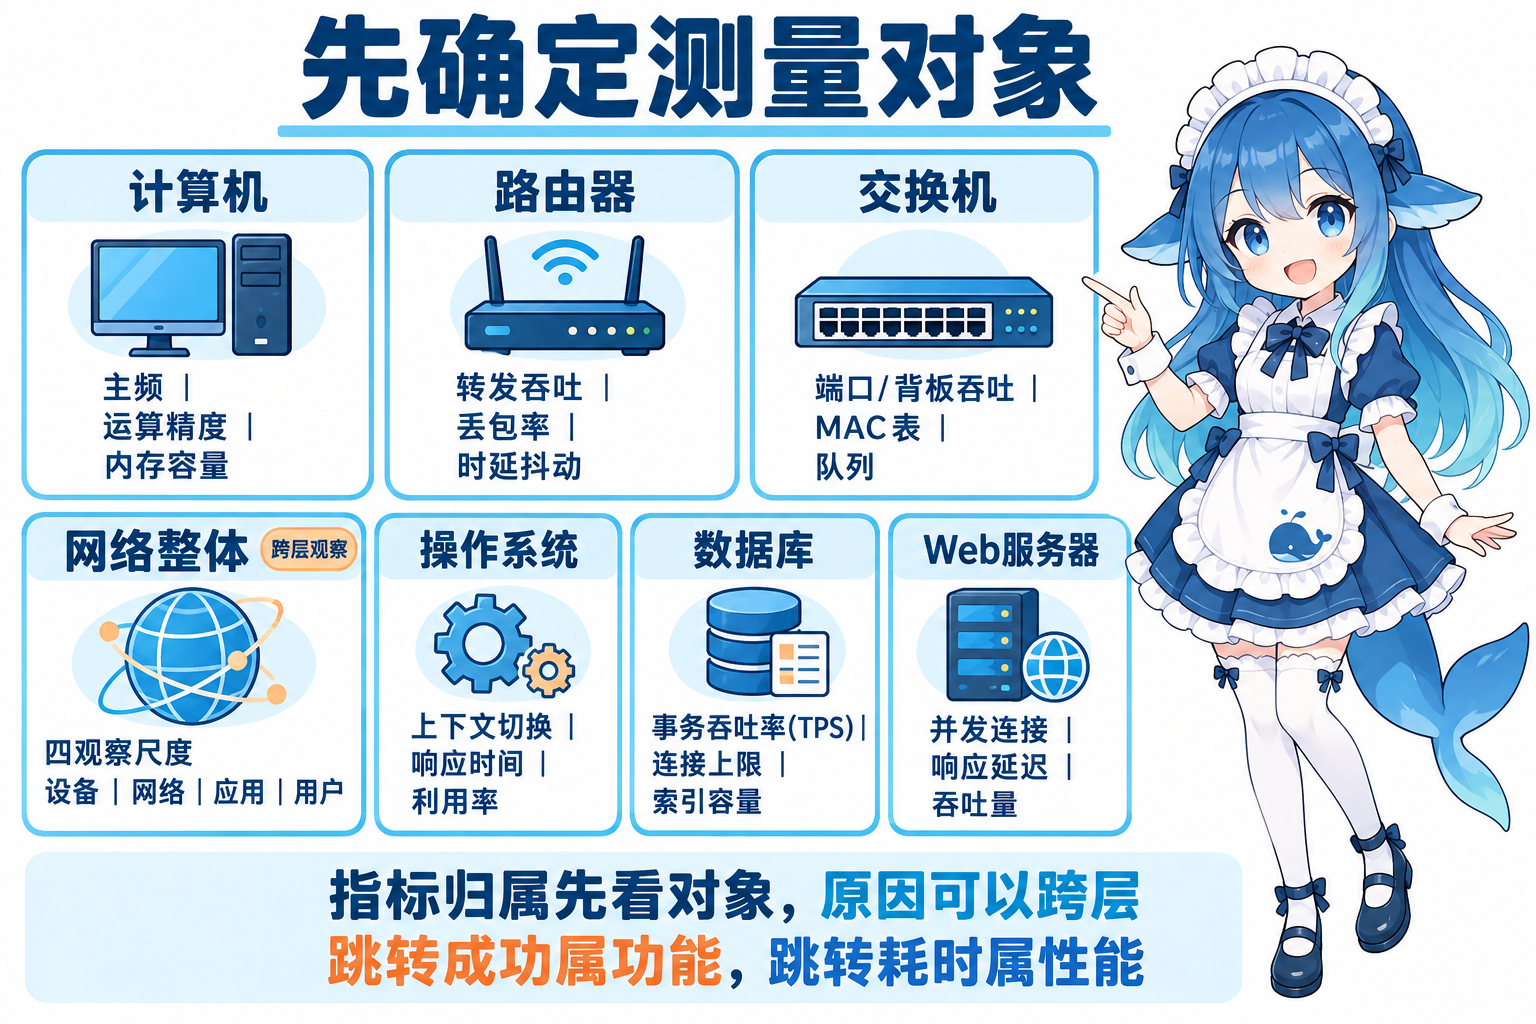
| 评价对象 | 本教材典型项目 | 使用时先确定什么 |
|---|---|---|
| 计算机 | 主频、运算速度/精度、内存容量与存取周期、数据处理速率 PDR(Processing Data Rate)、吞吐/响应/利用率、RASIS、扩展能力与性能价格比 | 是部件的时钟、程序的实际耗时,还是容量/质量属性?主频不能独自代表完成同一业务的速度。 |
| 路由器 | 设备/端口吞吐、转发能力、丢包、时延/抖动、路由表/队列和协议支持 | 分组大小、方向、流量与负载条件。支持一种协议是能力项,转发多少分组每秒是速率项。 |
| 交换机 | 端口/背板吞吐、MAC 表、队列、转发和管理支持 | 端口还是整机;二层设备还是题设的多层交换机。教材历史协议列举不等于每台设备都必须支持。 |
| 网络整体 | 设备、网络、应用、用户四种观察尺度 | 哪一段链路或哪条端到端路径。四尺度是看系统的角度,不是四个性能数值。 |
| 操作系统 | 响应、吞吐、资源利用、上下文切换、可靠性、可移植性 | 资源与采样窗口;切换次数是观察,不能用固定次数阈值断定所有硬件都已饱和。 |
| DBMS | 事务处理吞吐、连接上限、表/索引容量与处理能力 | 事务/查询的内容与并发、数据规模、正确结果。连接上限是可配置容量,不等于每秒完成的事务。 |
| Web 服务器 | 并发连接、响应延迟、吞吐量 | 连接、请求还是登录用户;成功业务数还是所有定义内的请求;均值还是分位数。 |
因此,“链接能正确跳转”首先检验功能正确性;“跳转用了多久”才是另一个耗时指标。一次功能通过不能代替性能测试,性能好也不能代替返回结果正确。数据库调优可以观察宿主 OS 的上下文切换,也可以调查网络时延;教材某道归属题把它们排除出 DBMS 的主要指标,并没有禁止工程排查。
吞吐、响应与在途量:三个量要在同一个框里
在预约服务边界内,先把排队与服务都纳入请求逗留时间。用 X 表示同类请求的长期有效完成率(请求/s),R 表示平均逗留时间(s),N 表示系统内平均在途请求数(请求)。在稳定、同边界、同类流量与合适长期平均的条件下,Little 关系为 N=X×R。有拒绝或失败时,先说明它们有没有进入所选系统及计数范围,不能随手把成功预约数、瞬时登录数和 p95 响应拼成同一个公式。MIT 的排队关系说明也明确区分系统与纯队列,以及真正进入系统的有效率。
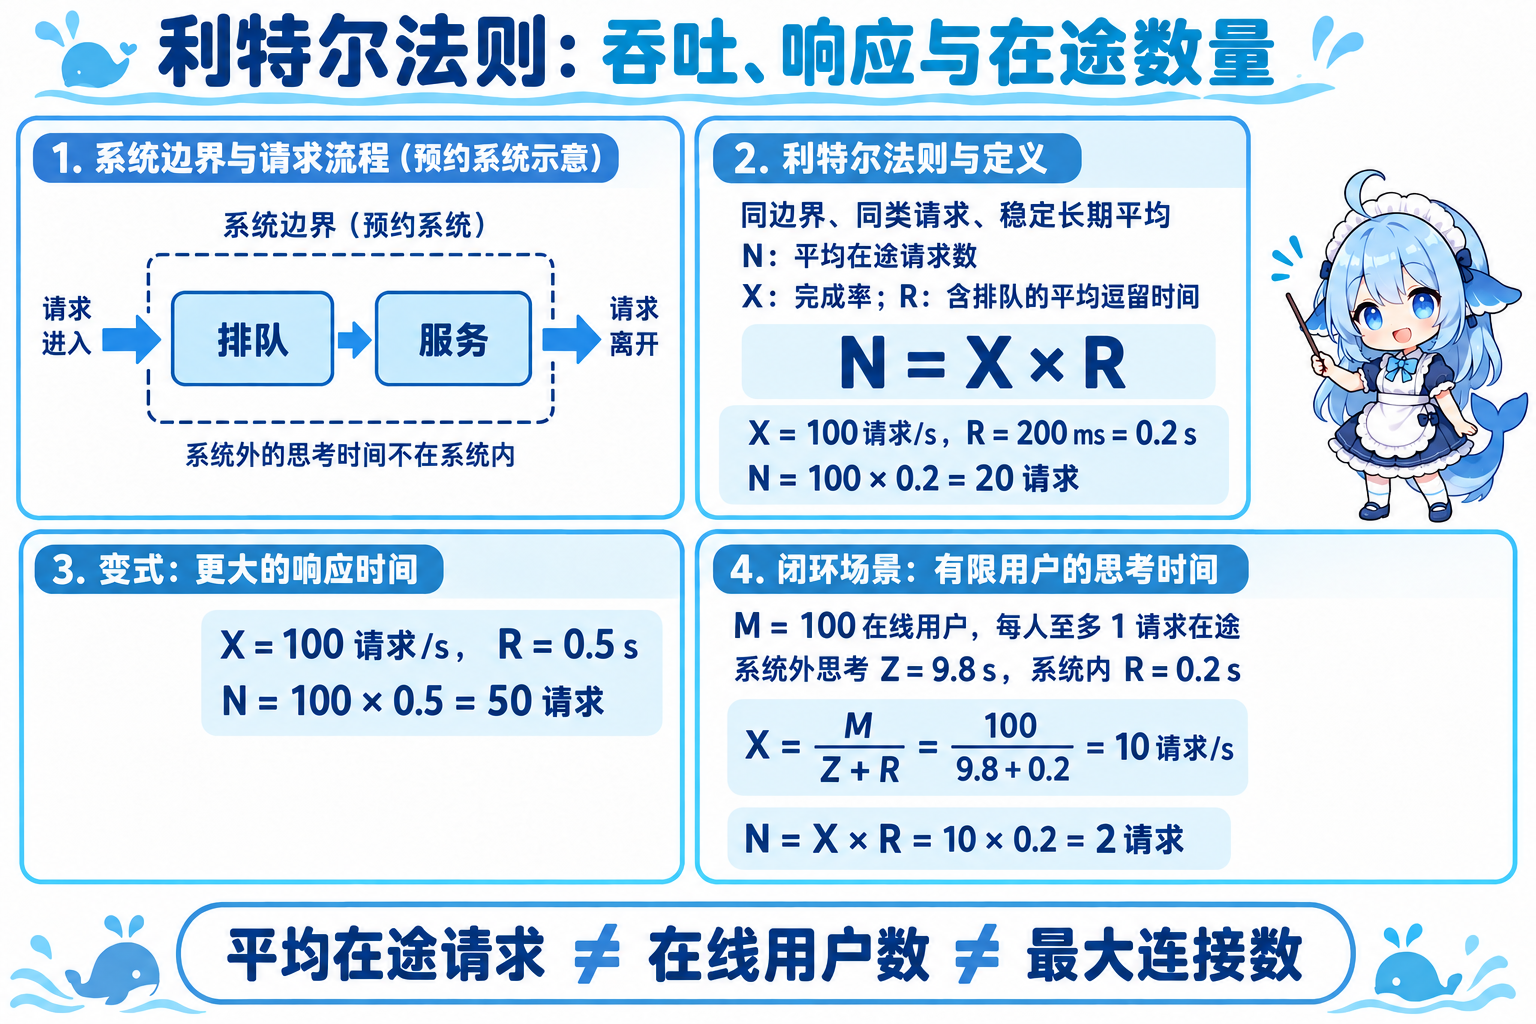
先求一个完整例子的平均在途量:已知稳定完成率 X=100请求/s、平均响应 R=200ms,并且两者来自上述同一边界。单位先换成 200ms=0.2s,再代入 N=(100请求/s)×0.2s=20请求。秒消掉,留下请求数,结果精确。这里的 20 是平均在途请求,包含排队和正在服务的请求;不要求每一瞬间恰好有 20 个请求。
现在只改变平均响应到 0.5s,仍给出 X=100请求/s,则 N=100×0.5=50请求,是原平均量的 2.5 倍。若题目反而给“平均在途仍为 20,平均响应为 0.5s”,同样的边界关系给 X=20/0.5=40请求/s。两个变式固定了不同变量,不能概括成“响应一变大,吞吐或在途必按某条普遍曲线变化”。具体负载曲线还取决于资源、队列、拒绝与系统实现。
把对象改为 100 个在线用户,情况又变了。假定这是封闭用户群,每人至多一个请求在途,收到响应后平均思考 Z=9.8s 再发下一次请求,系统内平均响应 R=0.2s。每个用户的平均周期是 Z+R=10s,所以系统完成率 X=M/(Z+R)=100/10=10请求/s;系统内平均请求数仍用 Little,得到 N=10×0.2=2请求。另有平均 10×9.8=98 个用户在系统外思考,2+98 回到总用户 100。直接算 100/0.2=500 的误用,是把全部在线用户都当成系统内在途请求并漏掉思考时间。
资源指标要换另一种分子。仍设稳定 X=100请求/s,但给单 CPU 每请求平均耗用 D=4ms=0.004s,且该 CPU 只承担这类请求、没有其它后台忙时间。每秒忙时间为 100×0.004=0.4s,CPU 利用率 U=XD=40%;只考虑 CPU 工时的理想吞吐上界是 1/D=250请求/s。若只把 D 改为 8ms,则同 X 下贡献为 80%,理想 CPU 上界为 125请求/s。这里 R 含等待,不能代替 CPU 服务需求 D;后台存在时,XD 只是这一类请求的忙时间贡献,不能冒称总 CPU 利用率。其它资源、正确性或延迟目标也可能使实际容量低于这个理想上界。
内存占用的分子是容量。6GiB 已占、总容量 8GiB,在相同统计定义下为 6/8=75%;把 6GiB 除以响应秒数不能得到这个容量比例。多核 CPU 百分比也要说明是按单核还是全部核归一化,不能把百分数名称相同当成口径相同。

RASIS 与可用性:正常时间、恢复时间先分开
本教材的计算机评价表用 RASIS 合并五项属性:可靠性 Reliability、可用性 Availability、可维护性 Serviceability、完整性 Integrity、安全性 Security。它是一组评价维度,不是系统生命周期的五个阶段,也没有包含本表另列的可扩充性。这里的 Security 不应改成嵌入式讨论人身风险的 Safety;后者在 2.4 的失效后果与安全设计中按另一问题讨论。
可靠度 R(t) 描述规定条件下连续无故障到时间 t 的概率;可用度描述所选时间范围里处于可用状态的比例。频繁故障但迅速恢复的系统可能有较高可用度,仍不能据此保证某段连续运行不发生故障。恢复时间是否包含发现、切换和重新提供服务,也会改变结果。
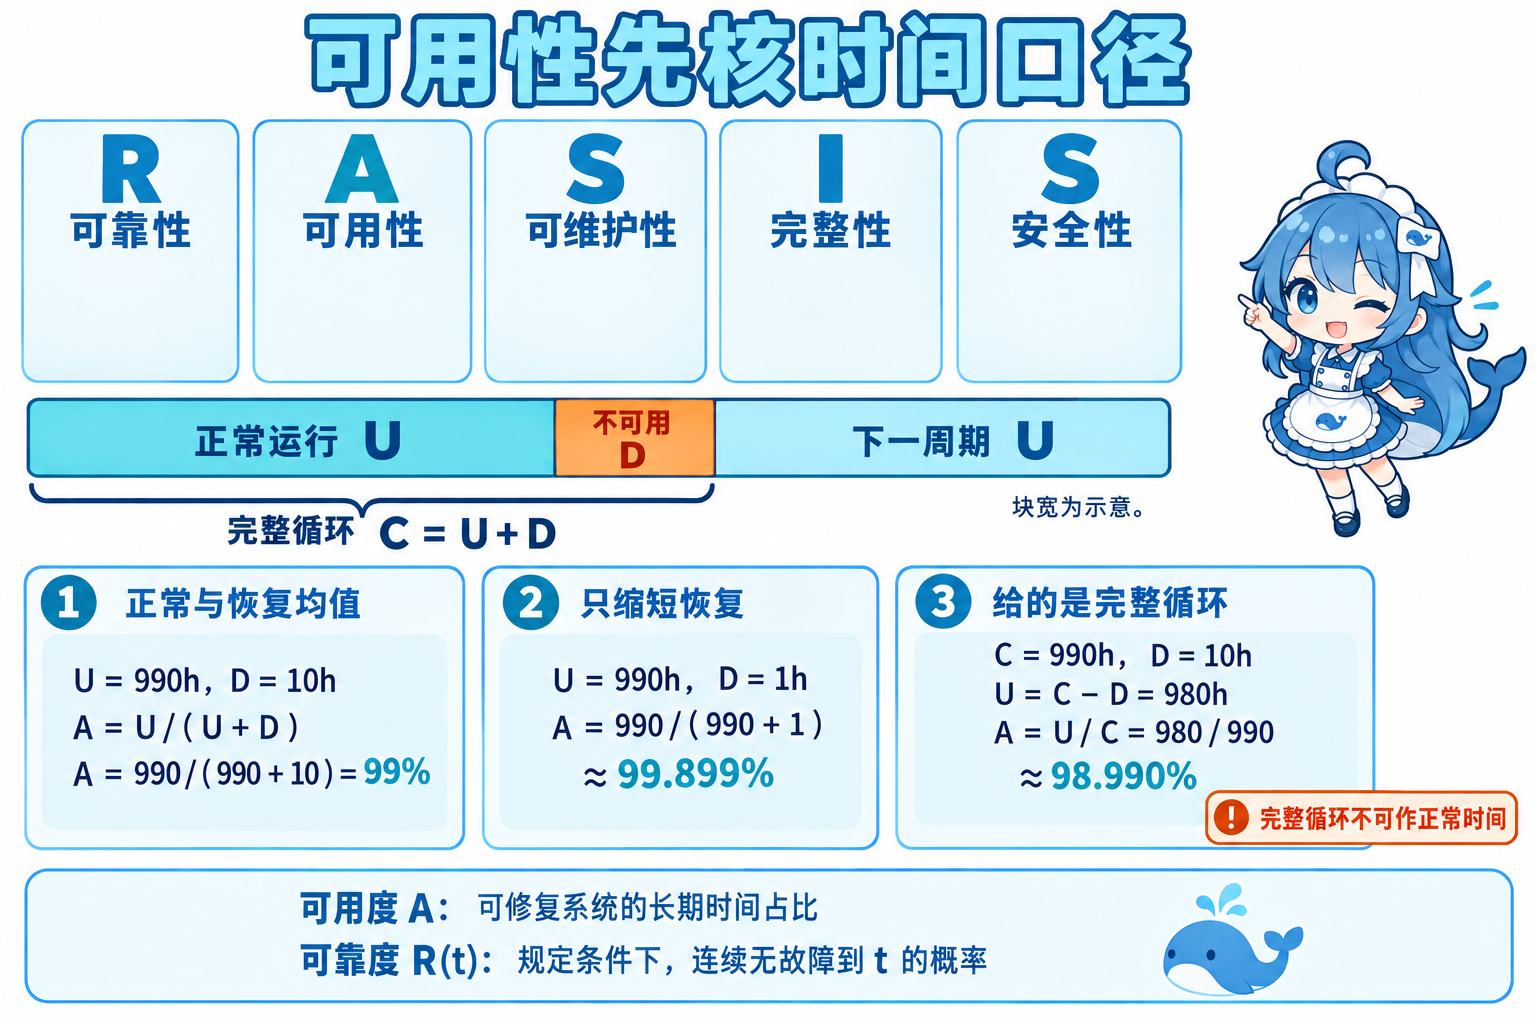
先不用有多种约定的缩写。设可修复系统长期平均正常段为 U=990h、平均不可用段为 D=10h,完整平均循环为 C=U+D=1000h;本例 D 已含该边界内全部不可用时间,不再另加停机。要算长期时间可用度,正常时间占完整循环,故 A=U/(U+D)=990/(990+10)=0.99=99%。小时相消,结果是无量纲比例。只改恢复段为 1h,正常段仍 990h,则 A=990/(990+1)=990/991≈99.899%,百分数按三位小数四舍五入;仍有非零不可用时间,不能说 100%。
若给的是“完整平均循环 990h,其中不可用 10h”,分母已经含 D。先求 U=C−D=990−10=980h,再算 A=U/C=980/990≈98.990%。如果又把 990 当正常段写成 990/(990+10),就改变了原题的分子、分母口径。所谓 MTBF 有时指平均正常运行时间,有时教材题明确指无故障与修复之和;前一种才能直接放进 MTBF/(MTBF+D),后一种则用 (MTBF−D)/MTBF。先读定义,不按缩写外形选公式。AWS 的可用性说明按正常运行与恢复的周期建模,NIST 的常率修复模型另给运行暴露时间的 MTBF 估计口径,都需要其自身定义。
观测窗口题可直接算时间比例:连续统计 30天,即 30×24=720h,定义内不可用共 2h,则 A=(720−2)/720=359/360≈99.722%;只改成 1h,则 719/720≈99.861%。这不是根据平均周期估计每次故障相同,也不是把“成功请求数/请求总数”自动转换为时间可用度。以请求成功率定义的业务指标可以使用,但必须另写分子分母。
同一字母在不同模型里可以重用。本页的 CPU 利用率 U 是无量纲比例,刚才的正常段 U 是小时;请求响应 R 是秒,可靠度 R(t) 是概率。先写定义与单位,才能知道当前式子里的字母在量什么。
2.9.2 性能计算:从指令耗时到整项任务
预约查询可以调用很多种指令。判断运算速度时,先确定题目给的是时钟周期、机器周期,还是一条指令的实际时间。对题设固定的顺序执行模型,T=指令数×平均CPI/时钟频率 中 CPI 是每指令平均时钟周期,频率用 Hz,T 用秒。时钟频率提高或 CPI 降低是否带来相同比例的业务收益,还取决于指令数、等待及模型是否保持。现代流水、超标量等实现可使平均 CPI 小于 1,不能把某道基本指令题的模型当作所有处理器的固定规律。
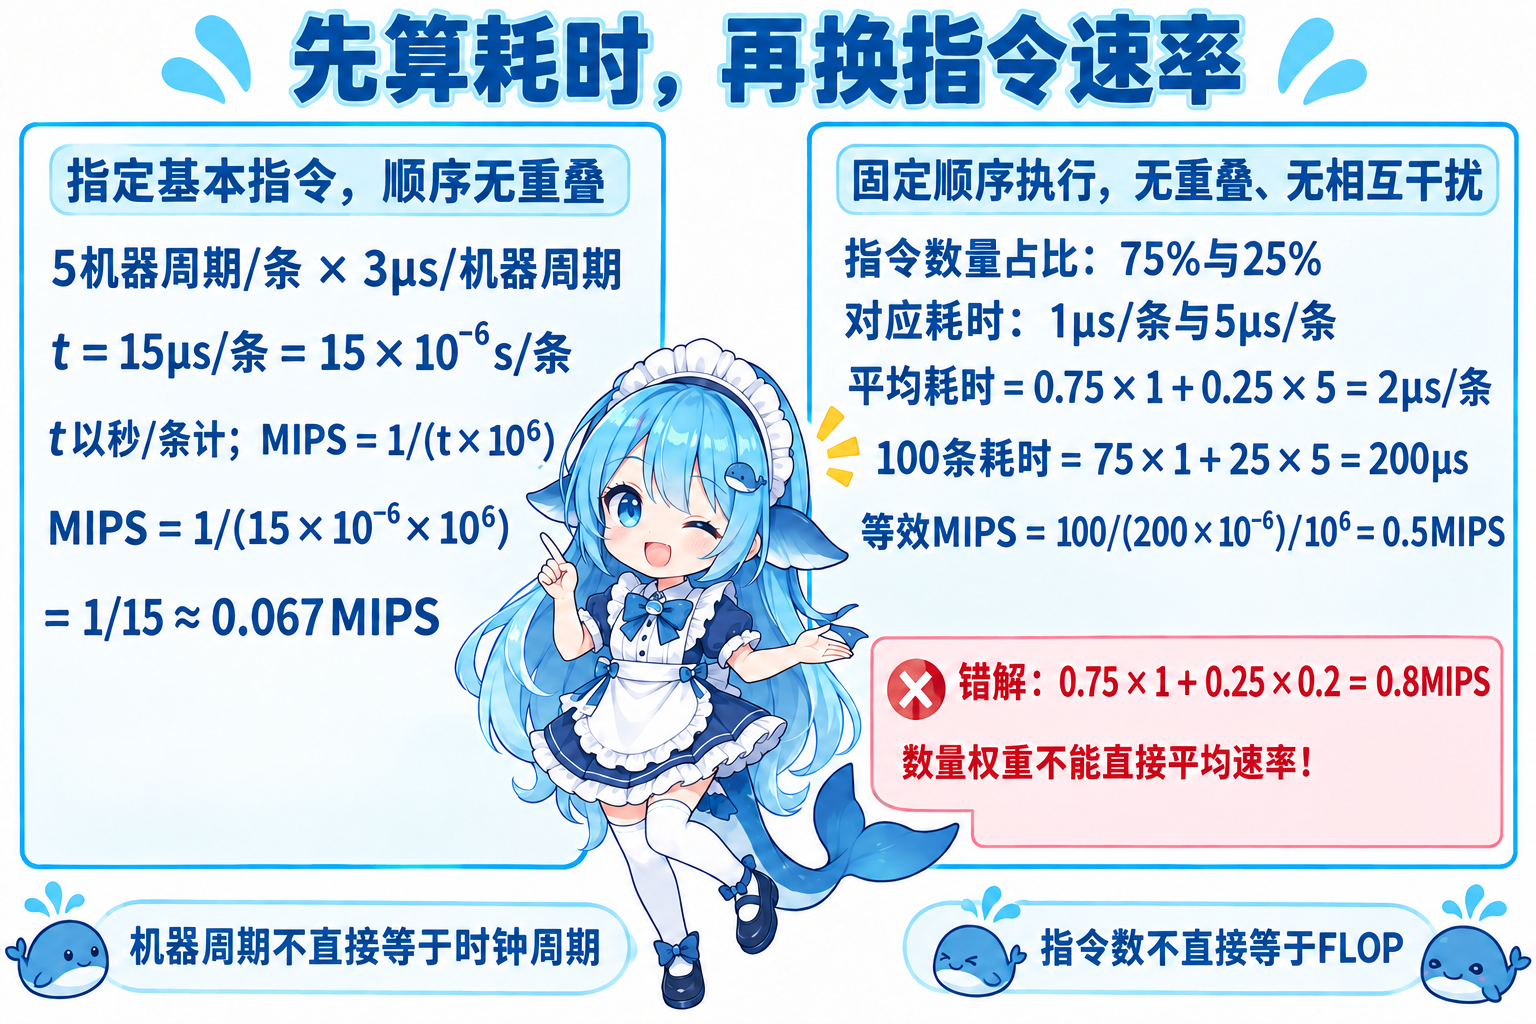
先算基本指令的 MIPS。这是对旧题数据作执行条件补全的改编:每条指定基本指令占 5 个机器周期,每机器周期 3μs;顺序执行,无重叠。所求是这个模型的指令完成率。t=5机器周期/条×3μs/机器周期=15μs/条=15×10⁻⁶s/条。于是每秒指令数为 1/t≈66666.667条/s,再以百万条/s 为单位,MIPS=1/(t×10⁶)=1/15≈0.067MIPS。这里的 0.067 按三位小数近似,精确值为 1/15。若改成 4 机器周期/条、500ns/机器周期,t=2000ns=2μs,得 0.5MIPS。只知道“5机器周期”不能直接写 CPI=5,除非另给一个机器周期就是一个时钟周期。
再把指令种类加入。固定顺序执行,无重叠、无相互干扰;按指令数量统计,75% 每条 1μs,25% 每条 5μs。平均每条耗时是 t̄=0.75×1+0.25×5=2μs/条。用 100 条作第二种核验,75 条耗 75μs,25 条耗 125μs,总共 200μs;MIPS=100/(200×10⁻⁶)/10⁶=0.5。若数量权重改为 25% 与 75%,平均耗时 4μs,得 0.25MIPS。不能把 1MIPS 与 0.2MIPS 按原数量权重平均成 0.8:慢指令占的运行时间更长。若权重本来就是运行时间份额,则可以按时间份额平均同口径速率;禁止的是把两种权重混用。
教材的“吉普森混合”采用代表性指令混合衡量处理器,不等于任何应用都拥有该混合。MIPS 数指令,MFLOPS 数浮点运算,也没有固定的一条指令等于一次 FLOP 的换算。自编例:规定口径下完成 600 万次浮点运算耗 0.2s,MFLOPS=6×10⁶/0.2/10⁶=30;只把耗时改为 0.1s,得 60MFLOPS。未给指令与浮点运算对应关系,不能用这两个结果反推 MIPS。不同指令集或不同程序之间也不能只按一个 MIPS 数字宣布业务更快。
理论峰值描述指定理想条件下的能力;持续成绩来自给定程序、负载、环境和统计窗口。刚才固定执行模型的纸上计算没有完成真实机器测试,不能把它直接标成实测持续性能。
教材把计算与测量方法概括为定义法、公式法、程序检测法、仪器检测法:分别从指标定义计数、按适用关系推导、运行指定测试程序、用测量设备观察。它们按取得结果的途径区分;写出一个公式不能代替实际程序或仪器测试。

CPU 与 I/O:先给下界,再构造能实现的排程
一批任务的周转时间不能把 CPU 与 I/O 工时全加起来,因为独立设备可重叠工作;也不能只算 CPU 总工时,因为任务可能还没到达或正在等 I/O。以下是对残缺旧记录另写的补全改编,没有冒称恢复原题最后一段:1 个 CPU、1 个独立 I/O 设备,各段不可抢占,切换开销为 0,除任务内顺序外没有额外依赖。P1 在 0ms 到达,依次 CPU40→I/O60→CPU40;P2 在 20ms 到达,依次 CPU100→I/O40→CPU40。求从 0ms 到两任务都结束的最短时间。
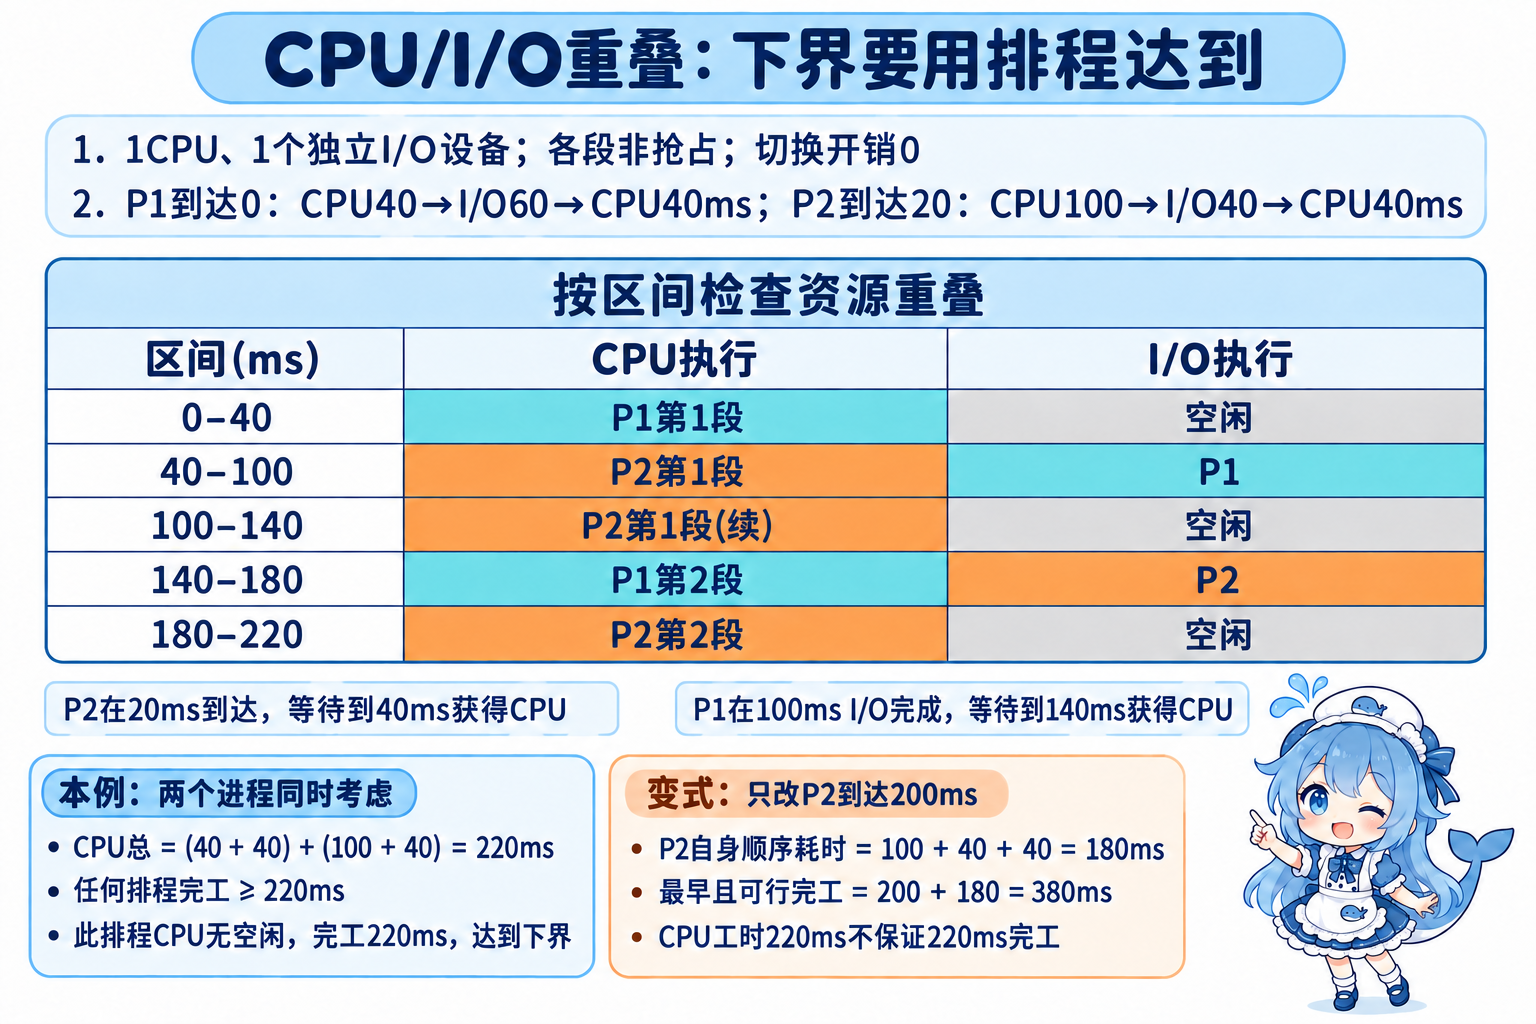
CPU 工时合计 40+40+100+40=220ms,故所有可行排程至少 220ms。构造如下:CPU 在 0–40 执行 P1,40–140 执行 P2,140–180 执行 P1,180–220 执行 P2;I/O 在 40–100 执行 P1,140–180 执行 P2。P1 的第二 CPU 段虽在 100ms 已准备好,但 P2 的不可抢占 CPU 段要到 140ms 才结束。每条任务链、到达时间和资源互斥都满足,且 CPU 全程忙,所以达到下界,最短完成时间是 220ms。
这段窗口的 CPU 利用率为 220/220=100%,I/O 利用率为 (60+40)/220≈45.455%;两任务的批次完成率是 2/0.22≈9.091任务/s。后者描述这批任务与这个窗口,不能直接声称长期系统容量就是该数。
只把 P2 到达改为 200ms,P1 可在 CPU0–40、I/O40–100、CPU100–140 完成。P2 在 CPU200–300、I/O300–340、CPU340–380 完成。它的链长 180ms、到达 200ms,给出下界 200+180=380ms;构造正好达到,最短 380ms,CPU 利用率 220/380≈57.895%。此时 220ms 总 CPU 工时仍正确,却达不到。把条件改成抢占、共享另一设备或加切换耗时,应重新建模,不能沿用原时间线。资源与状态机制可回看 2.3 操作系统。
Amdahl:局部变快,先追踪原来的时间份额
现在优化同一次预约工作:原总耗时 T₀=100s,其中可优化部分 60s,未优化部分 40s。条件是固定同一工作量,局部速度变成原 5 倍,未改部分耗时保持,无新增开销。定义 f 为可优化部分占原总时间的比例,k 为该部分的局部速度比,两者无量纲;本例 f=0.6、k=5。求整体速度比,需要先算新的总耗时。
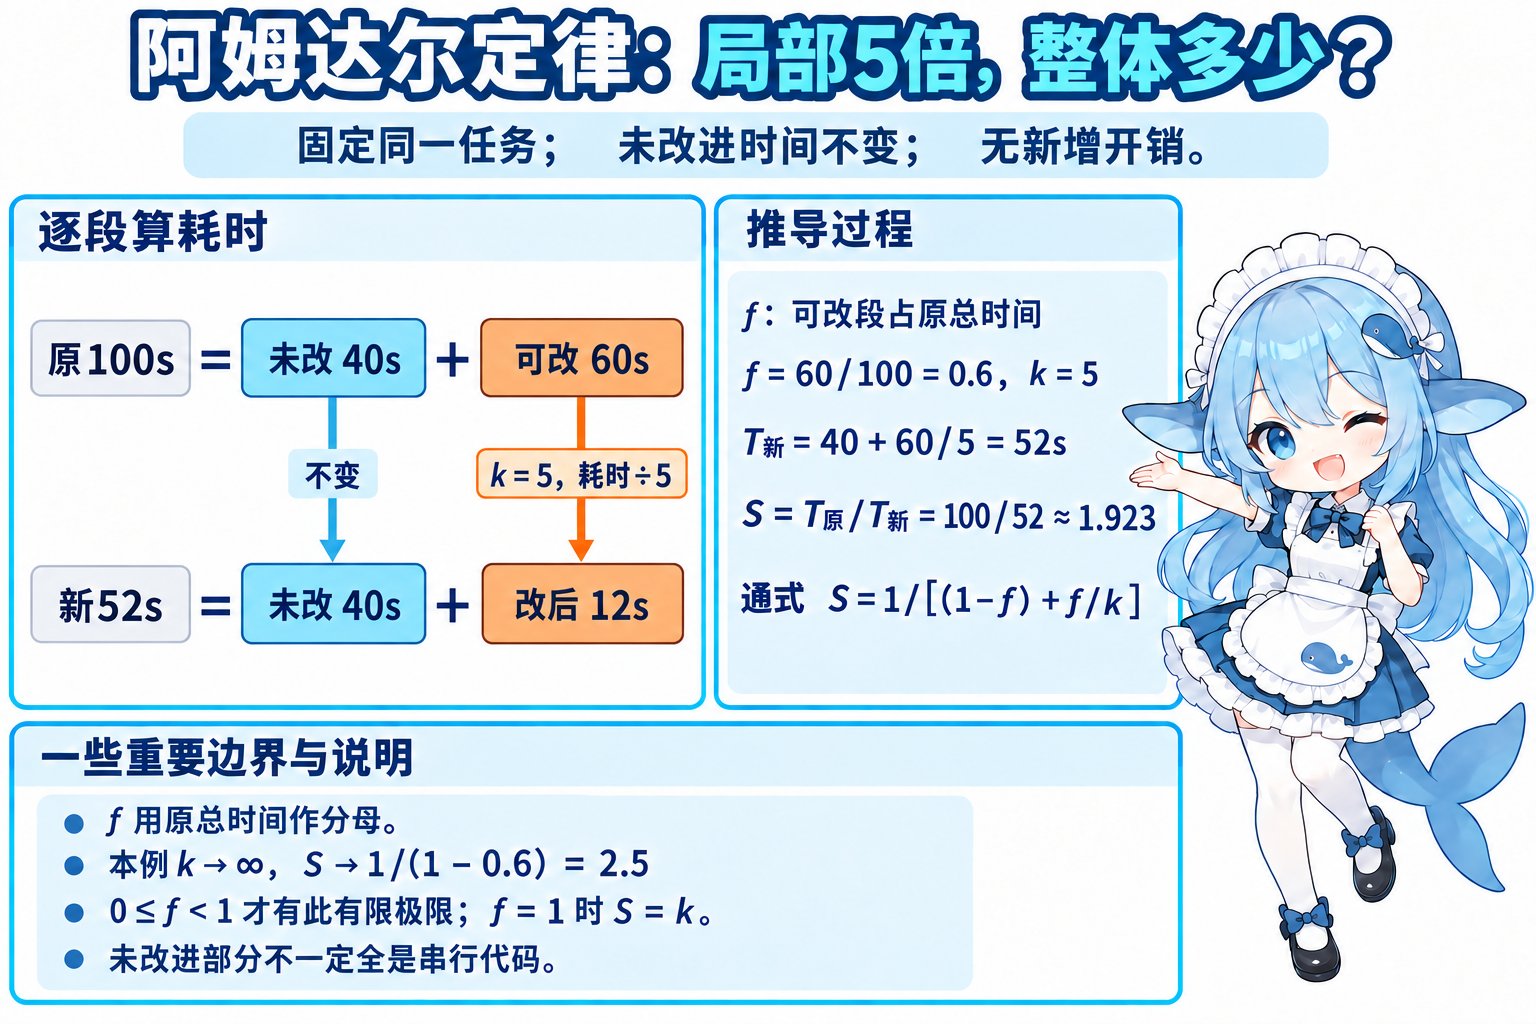
T₁=40s+60s/5=52s,所以 S=T₀/T₁=100/52=25/13≈1.923。通式从同一原基准拆开:T₁=T₀[(1−f)+f/k],约掉 T₀ 后为 S=1/[(1−f)+f/k]。整体提高到约 1.923 倍,耗时下降 48%;速度增长约 92.308%。二者分母不同,不能把下降百分数直接当速度增长百分数。新可改段占比是 12/52=3/13≈23.077%,不能用它替换原 f。
只把原可改比例变成 0.8,原任务仍 100s、k 仍 5,则新耗时 20+80/5=36s,整体比 100/36=25/9≈2.778。这说明决定收益的是局部倍数及原时间份额一起,而非局部倍数单独。回看极端:f=0 或 k=1,S=1;f=1,S=k;0≤f<1 且 k 趋向无穷时,S→1/(1−f),本例趋向 2.5,有限 k=5 的 1.923 还未达到。未改进部分可能包括串行代码、等待或其它未优化工作,题设没有授权把它一律叫“串行部分”。
题目若换成“优化后总共 100s,其中优化段占 60s”,给的是新的比例 q=0.6,不能套进刚才的原 f。仍给局部 k=5、未改段不变,逆推原可改段为 60×5=300s,原未改段 40s,原总 300+40=340s;S=340/100=3.4,原 f 为 300/340=15/17≈88.235%。
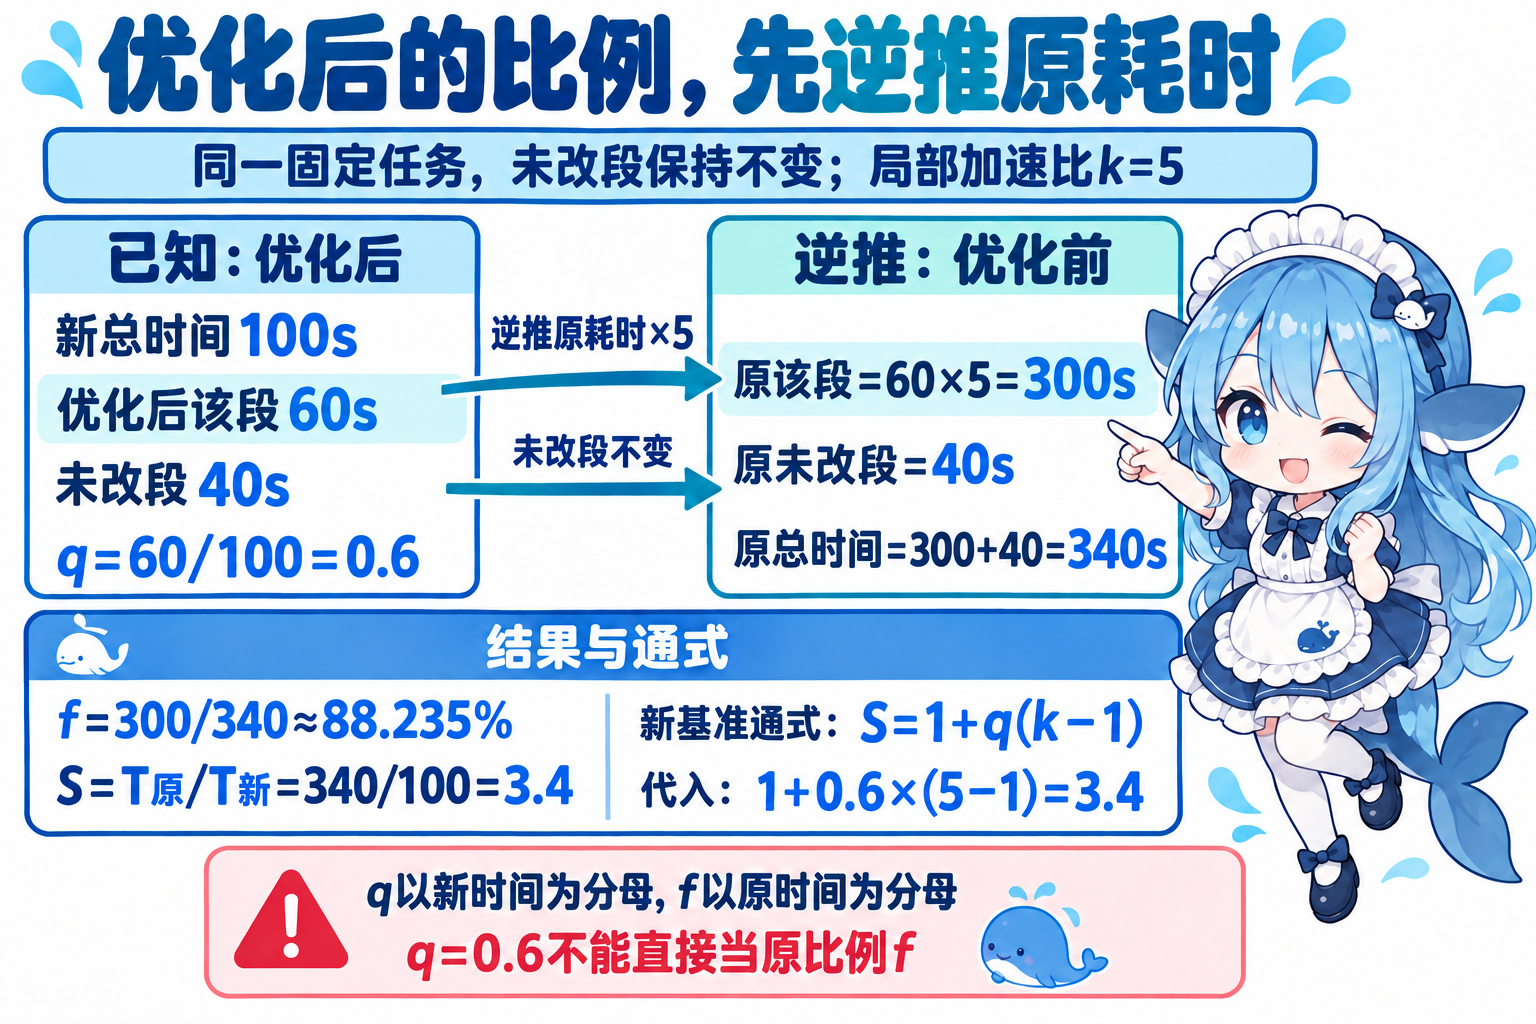
把新基准一般化:设新总 T₁,新可改为 qT₁,则原总为 kqT₁+(1−q)T₁,故 S=1+q(k−1),原比例 f=kq/[1+q(k−1)]。只改 q 为 0.2、k 仍 5,得到 S=1.8、f=5/9≈55.556%。这仍是同一固定任务的原新时间换算,未引入另一个定律或随资源扩大任务量的条件。
多处改进:互斥、包含与连续基准
把原 100s 分成互斥的 A60s、B20s、其余20s;A 局部 5 倍,B 局部 2 倍,无新增开销。三块原时间不重叠,分别除以各自速度比,再相加:T₁=60/5+20/2+20=42s,整体 S=100/42=50/21≈2.381。如果新增优化开销 8s,则总耗时改为 50s、整体比降为 2;忽略开销就换了条件。
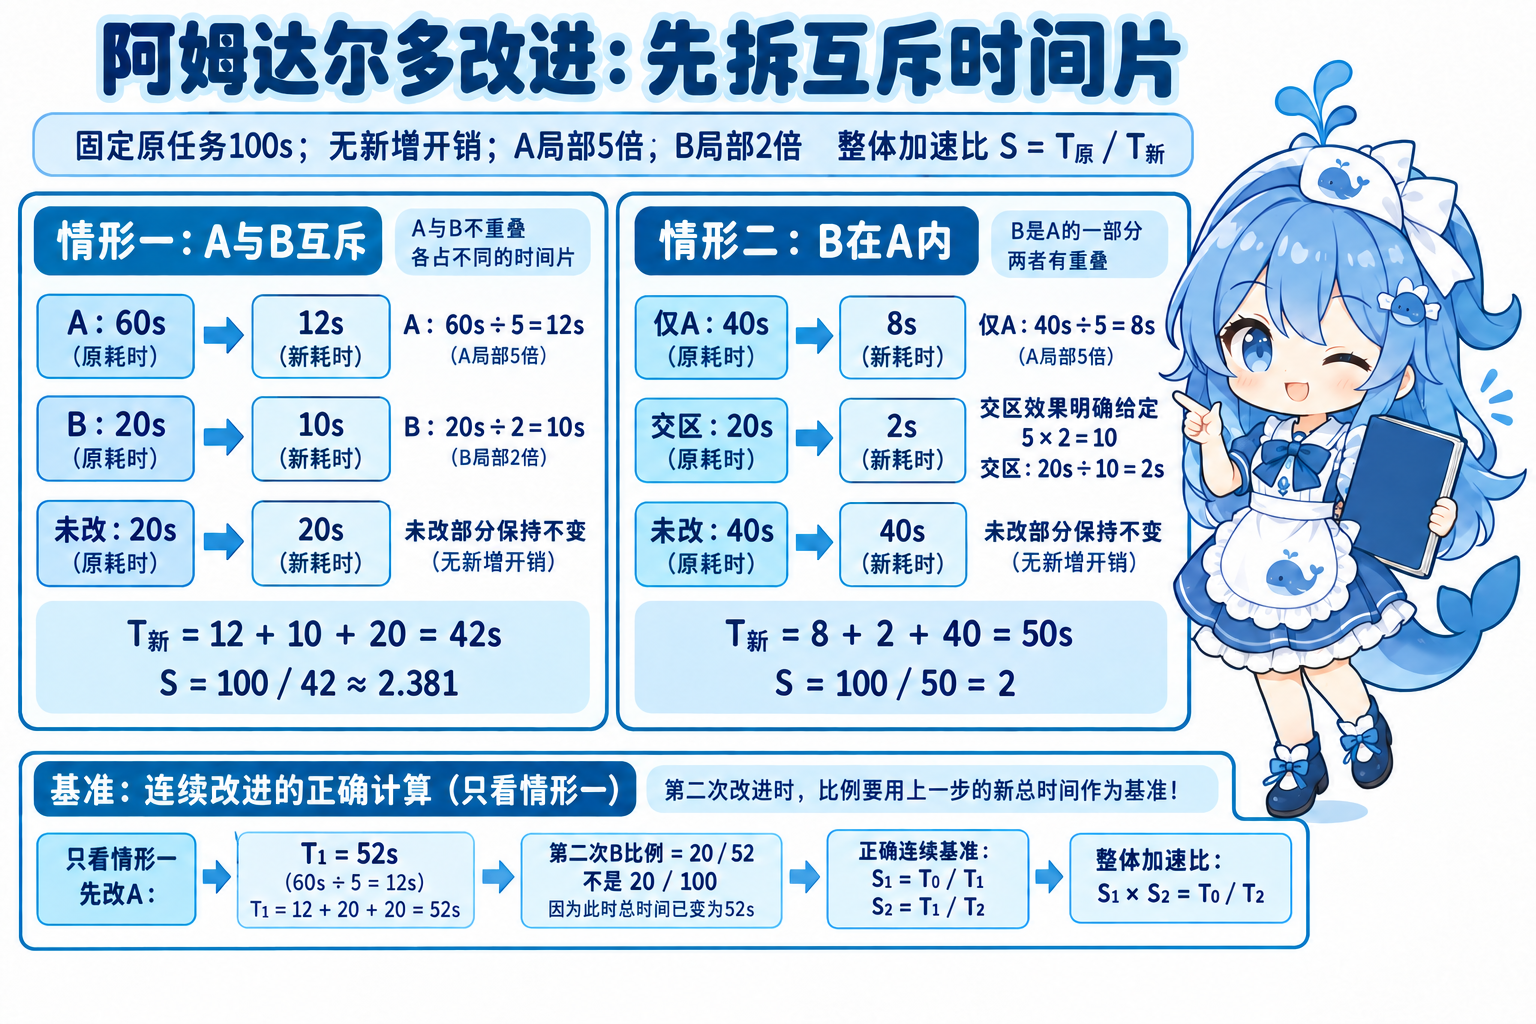
条件改成 B20s 位于 A60s 内时,需要重拆互斥片:仅 A40s、交区20s、未改40s。再明确给定交区组合效果为 10 倍,才有 T₁=40/5+20/10+40=50s,S=2。若组合效果未知,就不能自行乘 5×2;把 A60、B20、未改40 直接相加会把交区重复算一遍。
再回到最初互斥情况,按顺次改进理解:先仅改 A,新总 T₁=60/5+20+20=52s。第二次改 B 时,它占这一步原总的 20/52=5/13,而不是 20/100。第一次整体比 S₁=T₀/T₁=25/13,第二次整体比 S₂=T₁/T₂=52/42=26/21;连续分母相消,S₁S₂=T₀/T₂=50/21。所以不能笼统说整体比“绝不能相乘”;不能盲乘的是两个各自都基于同一最初任务、却假装第二次份额仍未变化的单独收益。
题给扩展模型:极限未必是上界
旧练习给相对性能模型 P(n)=n/[1+(n−1)a]。这里 n 是正整数处理器数,P(1)=1,P 与题给常数 a 无量纲,本节讨论 a≥0;它是题设模型,不是对任意硬件测出的普遍性能曲线。改写成 P(n)=1/[a+(1−a)/n],更容易看出扩大 n 后的趋势。
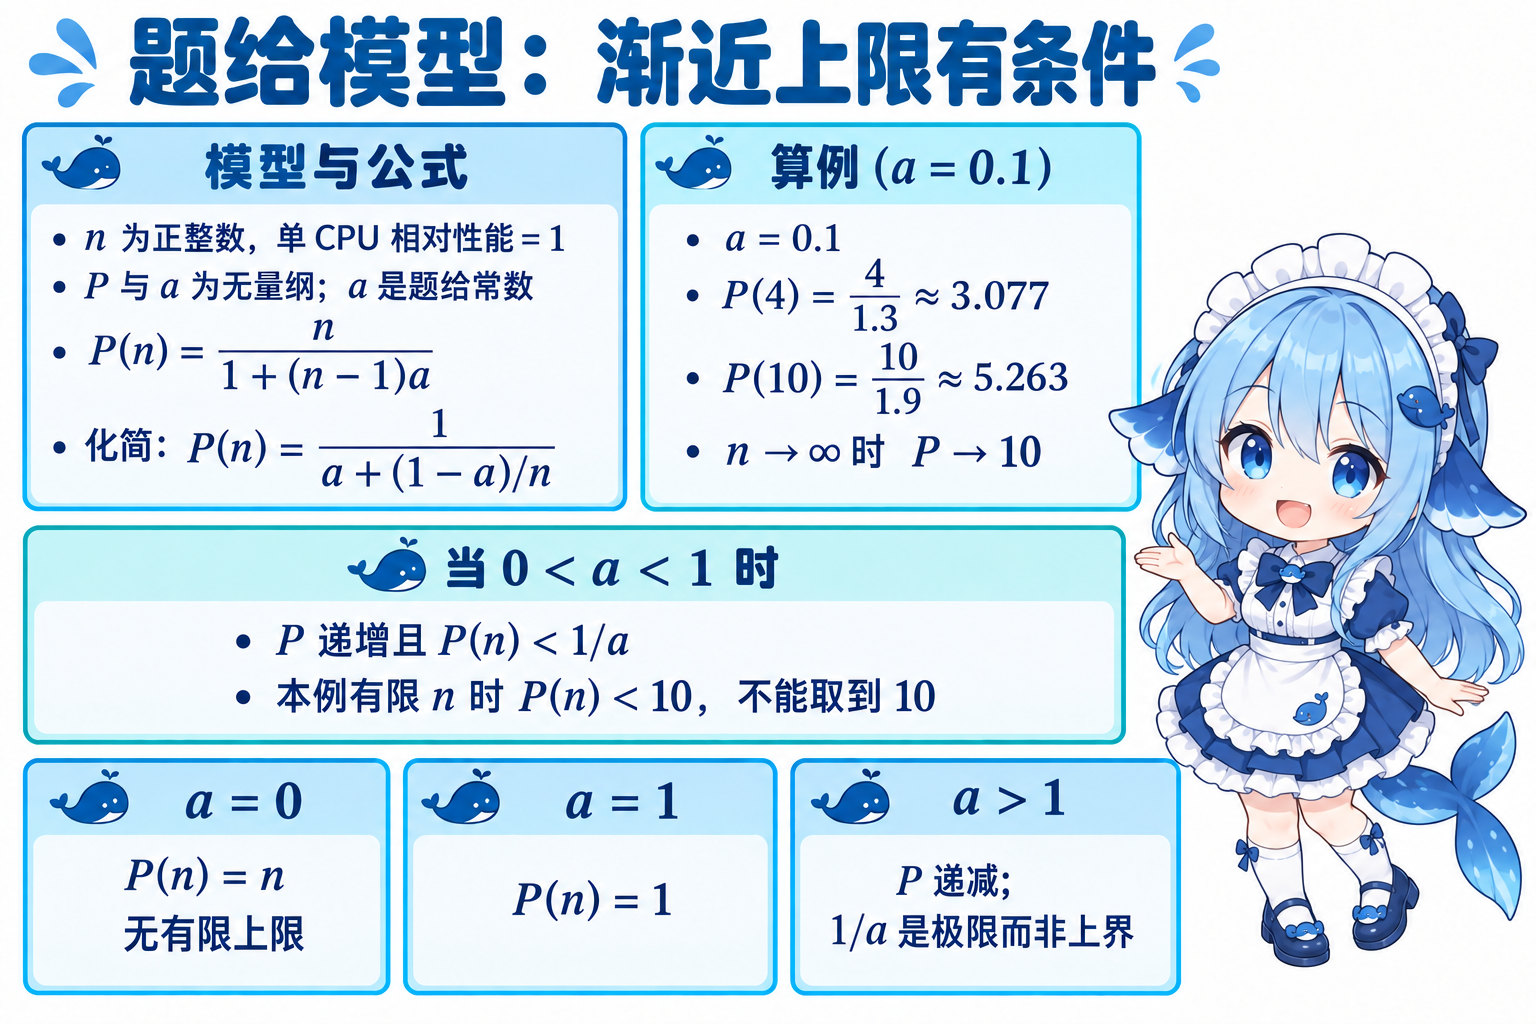
设 a=0.1:P(4)=4/1.3=40/13≈3.077,P(10)=10/1.9=100/19≈5.263;比值结果按三位小数近似。若 0<a<1,分母随 n 增大而减小,但始终大于 a,故 P 严格递增、P(n)<1/a,趋向 1/a。本例上确界为 10,有限 n 不能达到。只把 a 改成 0.2,则上确界改为 5。
改变范围会改变结论:a=0 时 P(n)=n,无有限上界;a=1 时 P(n)=1,已经等于 1/a;a>1 时,分母从 1 向 a 增大,P 递减,趋向 1/a,但 P(1)=1>1/a,所以极限不是这串性能值的上界。不能只求到“1/a”就无条件回答最高性能,也不能未经题设解释,把 a 精确认作通信延迟或串行代码比例。
2.9.3 性能设计:给调优建立可比较的边界
前面的 Amdahl 时间分解正式对应教材这里的“阿姆达尔解决方案”。它帮助判断局部改进的可能收益;实际设计还要证明确有那段耗时,以及新方案有没有增加其它开销。预约变慢时,先给三个输入:资源与业务约束、指定工作负载、性能目标。负载应说明数据规模、请求内容与发起方式;目标应说明吞吐、时延、错误或可用性如何统计。没有这些输入,修改前后两个数字很难支持同一个结论。
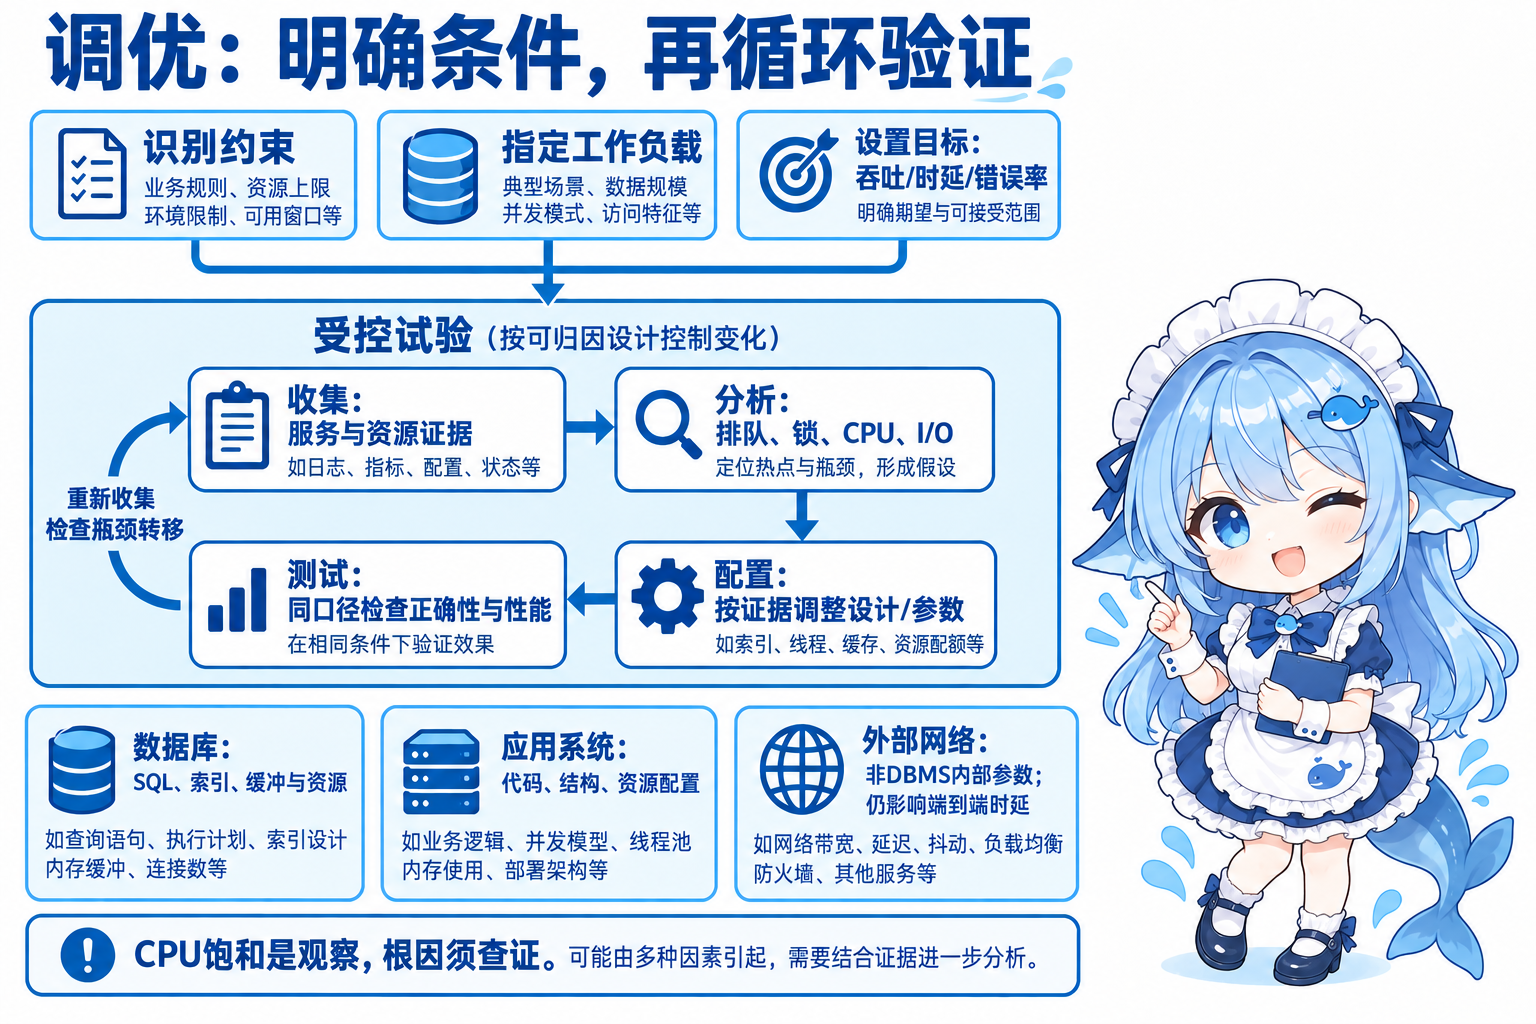
教材循环是收集、分析、配置、测试。收集服务侧和资源侧证据,包括延迟分布、完成/错误数量、资源窗口、等待状态与配置;分析具体时间花在哪里,形成可验证的假设;配置按该假设调整设计或参数;测试在相同计数定义和可比较负载下,检查正确结果与性能是否达标,再收集证据看瓶颈是否转移。受控试验要能归因,常用小范围变化;比较一组预先设计的配置也可以,不必把“受控”解释成任何试验永远只能改一个参数。
数据库调优看 CPU/内存、数据库设计与管理、进程/线程状态、磁盘剩余空间、日志等;应用调优看可用性、响应时间、并发用户与特定应用资源。网络吞吐配置通常不是 DBMS 内部参数,却可以影响用户端时延。缓存容量、线程数或连接上限加大都有资源代价;例如 PostgreSQL 的连接配置说明 max_connections 关联资源分配,不能据此推成加连接必增 TPS。
CPU 饱和是观察结果。要区分确实需要更多算力,还是当前查询/算法消耗了本可避免的计算;活动查询还可能在等锁或 I/O。平均响应快,也可能同时存在一批很慢的请求。Google SRE 的监视讨论区分症状与原因,并提醒均值不能代替尾延迟。沿同一负载比较服务表现与内部证据,才知道收益能否迁移到实际使用。
跨章学习记录中有至少三次独立错误集中在架构评价的“敏感点”判别。这里补理解调优所需的边界:某参数改变显著影响一个质量属性,可成为敏感点;若它同时影响多个质量属性并需要取舍,还需分析权衡。单次修改后某指标变好,不能就把所有参数都称为敏感点。记录是哪种负载、哪个参数、影响了哪个属性,才能回到原评价场景。架构评价的完整方法仍留在对应章节,本节不把它新增为正式2.9.5。

2.9.4 性能评估:选工作负载,再解释分数
评估要服务一个具体目的:比较候选系统、检查容量边界,或验证持续运行。按目的选度量项目,通过模型和实验检测,解释结果并形成记录;一个最高分数不自动回答所有业务问题。教材列出的四种评价程序、标准化套件、Web 测试目的、系统监视途径,使用不同分类轴。
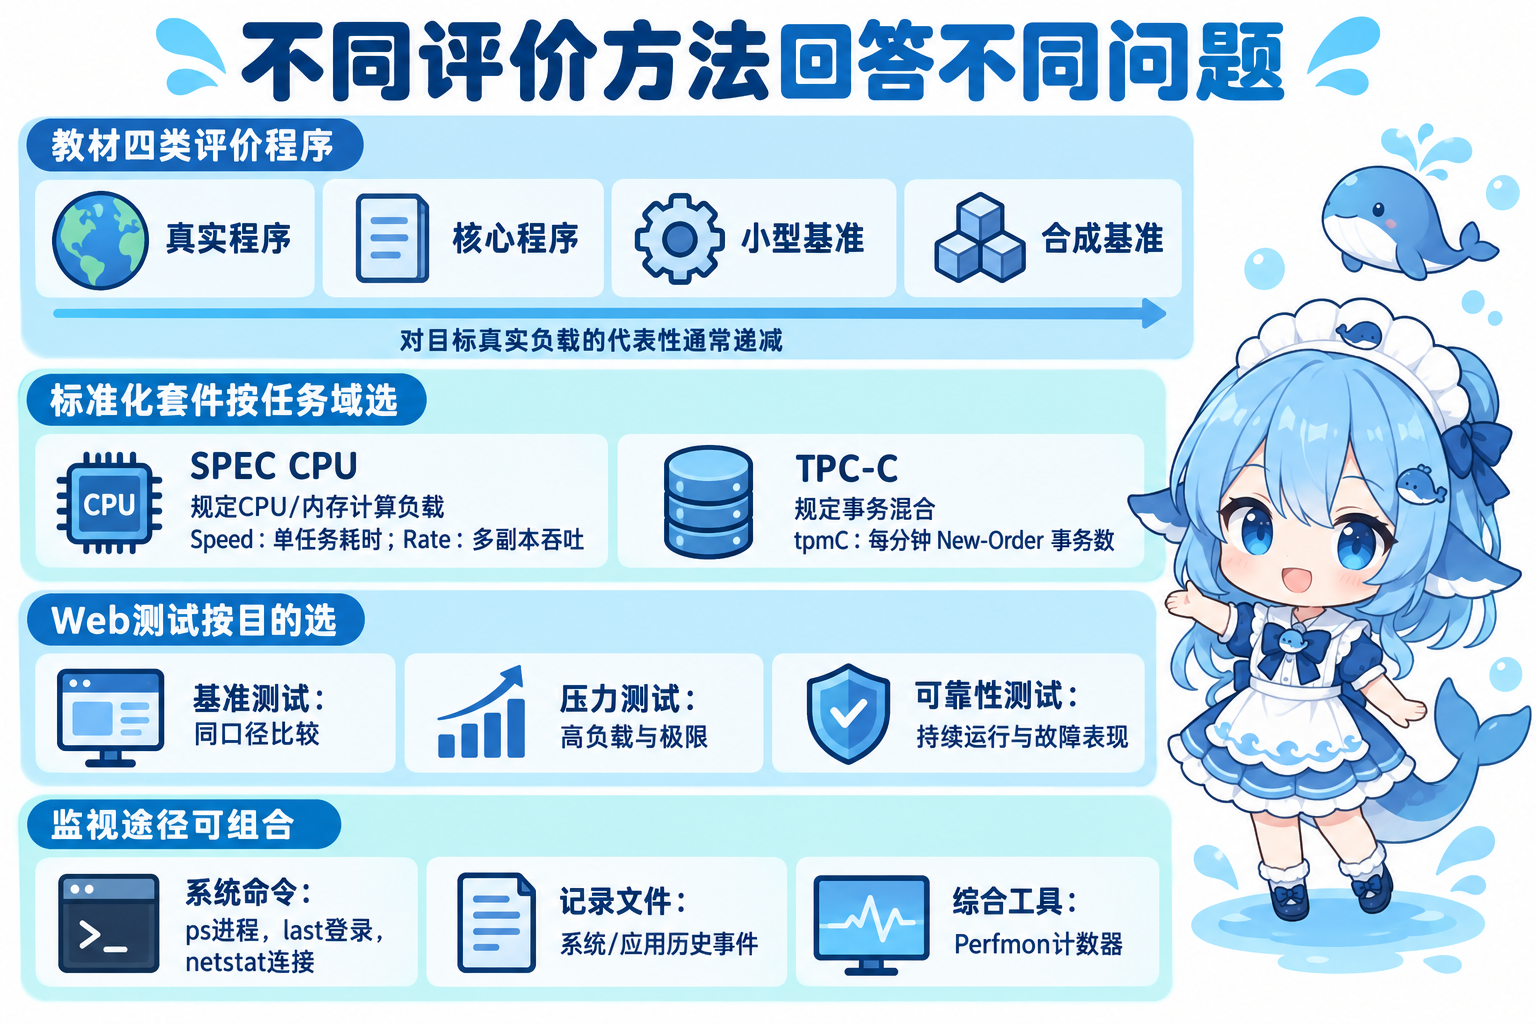
| 教材评价程序 | 如何选取 | 可以怎样理解代表性 |
|---|---|---|
| 真实程序 | 运行实际目标应用 | 更接近该目标,仍要给实际数据与负载。 |
| 核心程序 | 抽取应用中频繁使用的关键部分 | 有代表性但省略其它路径与交互。 |
| 小型基准程序 | 以小程序集中测试某类操作 | 容易重复,覆盖范围更窄。 |
| 合成基准程序 | 按规定混合构造测试负载 | 便于比较,混合是否代表目标仍须判断。 |
教材按上述顺序概括评测准确程度递减,理解为相对于目标真实负载的通常代表性,不能宣布所有真实程序结果都比任何规范测试更精确。Dhrystone 主要是整数类基准,Linpack、Whetstone 属浮点测试;SPEC 与 TPC 是规定工作负载和规则的套件体系,不能拿“SPEC综合”取代教材第四类,也不能把不同套件分数直接互换。
SPEC CPU2017侧重处理器、内存层次与编译器,SPECspeed 关注规定任务耗时,SPECrate 关注多副本吞吐;它不以网络、图形或 I/O 压力作为该套件目标。TPC-C Revision5.11则规定事务混合,tpmC 数每分钟 New-Order 事务的规范计入完成量,包含该规范指定的回滚范围;它不是五类事务总数,也不是所有 TPC 产品统一使用的指标。tpmC 数量还必须在响应时间及其它规则条件下解释,不能以最高瞬时数字冒称合规评测。
一个“平均”也可能改变比较目的。完整自编例:同样两个任务,参照机 A 耗时 10s 与 20s,待测机 B 为 5s 与 40s。定义 B 相对 A 的速度比为 A时间/B时间,分别得 2 与 0.5。若当前评分规则要求等权几何均值,则 G=√(2×0.5)=1,无量纲;算术平均 1.25 不是这个 G。交换参照后两比变成 0.5 与 2,G 仍为 1,而算术均值仍是 1.25,无法与原算术结果互为倒数。
若实际业务是两任务各串行执行一次、没有重叠或额外耗时,应直接加工作时间:A总=10+20=30s,B总=5+40=45s,批次速度比 30/45=2/3。若改成第一任务执行 9 次、第二任务 1 次,A总=9×10+20=110s,B总=9×5+40=85s,批次比 110/85=22/17≈1.294。几何均值 G 仍按原评分任务等权求;业务组合已经改变,不能从 G=1推得任意组合一样快。若业务改并行执行,必须按资源与排程重新求完成时间,不能再无条件加总。SPEC CPU2017 套件归一化比值用几何均值,不代表所有性能指标都应这样平均。
Web 测试另按目的分:基准性能测试在可比较负载下建立参照;压力测试观察高负载、极限与退化;可靠性测试观察持续运行及故障表现。三者可以共用并发连接、响应延迟、吞吐等指标,但测试条件与所支持的结论不同。“链接跳转是否正确”是功能检查;衡量跳转耗时需增加时间测量。可靠性测试通过也不能证明系统永不失效。完整记录至少说明环境/版本、负载、结果正确性、统计窗口、重复规则与限制。

监视:命令、日志与集成工具可以组合
教材的三个途径为系统命令、系统记录文件,以及集成命令/记录/可视化的工具。ps 观察进程,last 查登录历史,netstat 观察网络连接等;Perfmon 是 Windows 的计数器/监视工具。它们服务不同对象,工具名称不是独立性能指标,也不是三个必须依次执行的阶段。
累计日志能回看已发生的事件,采样工具能观察当前窗口,集成界面可把多类证据关联。解释 CPU 百分数要用对应窗口的计数变化,并说明核归一化;Linux iowait 有多核与计数限制,不能凭一个字段直接确认磁盘根因。数据库的累计统计也可能延迟刷新或在事务中缓存,不能把两个不同快照随意当成严格同一时刻。归档满了是否覆盖、停采或轮转,检查点怎么触发,均需特定系统策略;本节不采用“所有日志满必全停”一类无实现条件的规则。
已核数学扩展:先描述集合与可行约束
旧知识点中把容斥和线性/整数约束编到2.10以后的编号,并不使它们成为本教材新增小节。以下按 Goal 纳入已核扩展,帮助练习“条件改变就改模型”。CSP 推理另有记录,可用完整约束求解;本节不把残缺分支补成原题,也不扩写安全法规、CORBA 或 RAID 的其它整章,相关归属见来源表。
容斥:把重叠计数还原为互斥区域
改编例给全集 100人,A 会 Java 的45人,B 会C语言的53人,C 会Python的55人;|A∩B|=28、|B∩C|=32、|A∩C|=35,均包含三种都会的20人。求都不掌握的人数。人数是集合基数,圆面积不按人数缩放。
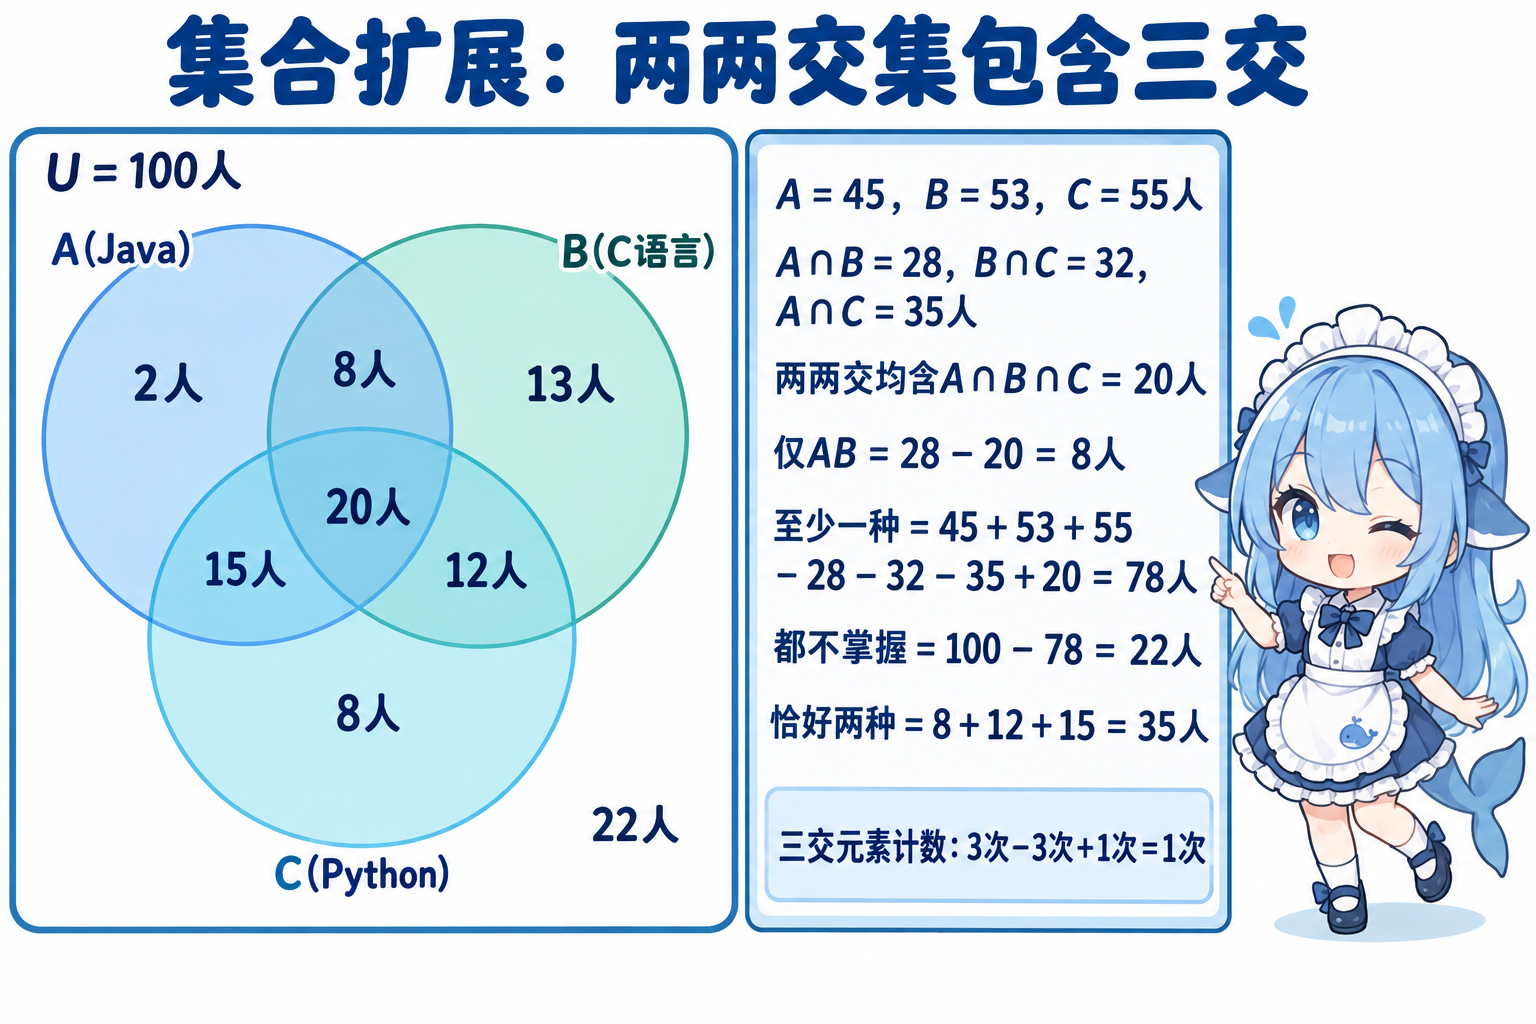
先求至少一种:|A∪B∪C|=45+53+55−28−32−35+20=78人;补集为 100−78=22人。一个三者都会的元素,先被三个单集合算3次,再被三对交集减3次,最后加回1次,得到正确一次。用互斥区核验:仅A=2、仅B=13、仅C=8,仅AB=8、仅BC=12、仅AC=15,三交20、补22;八区总和100,回代A=2+8+15+20=45,其余两集合也回到53、55。恰好两种是 8+12+15=35人,不能把两两交集95当成互斥人数。
变式给全集60人,A32/B28/C25,两两AB14/BC12/AC15且含三交6。并集 32+28+25−14−12−15+6=50人,补集10人;互斥单区9/8/4,双区8/6/9,三交6,合50人,另加10回60。若把原28/32/35改为“只会这两种、不含第三种”,却仍保留原单集合和三交20,则仅A=45−28−35−20=−38,数据矛盾。此时不是换个容斥符号便能得到合法人数,必须先查清输入语义。
线性目标与整数约束:上界还要有可行点达到
改编完整数学模型:x,y为非负整数;x≤4,y≤3,x+2y≤8,最大化 z=2x+3y。这里 x、y 和 z 使用抽象数学单位,没有另给金钱或时间。先暂时放宽为实数,连续可行域的五个顶点为 (0,0)、(4,0)、(4,2)、(2,3)、(0,3),目标分别0/8/14/13/9,连续最优14在(4,2)。该点也是整数,因而整数问题也能达到14。
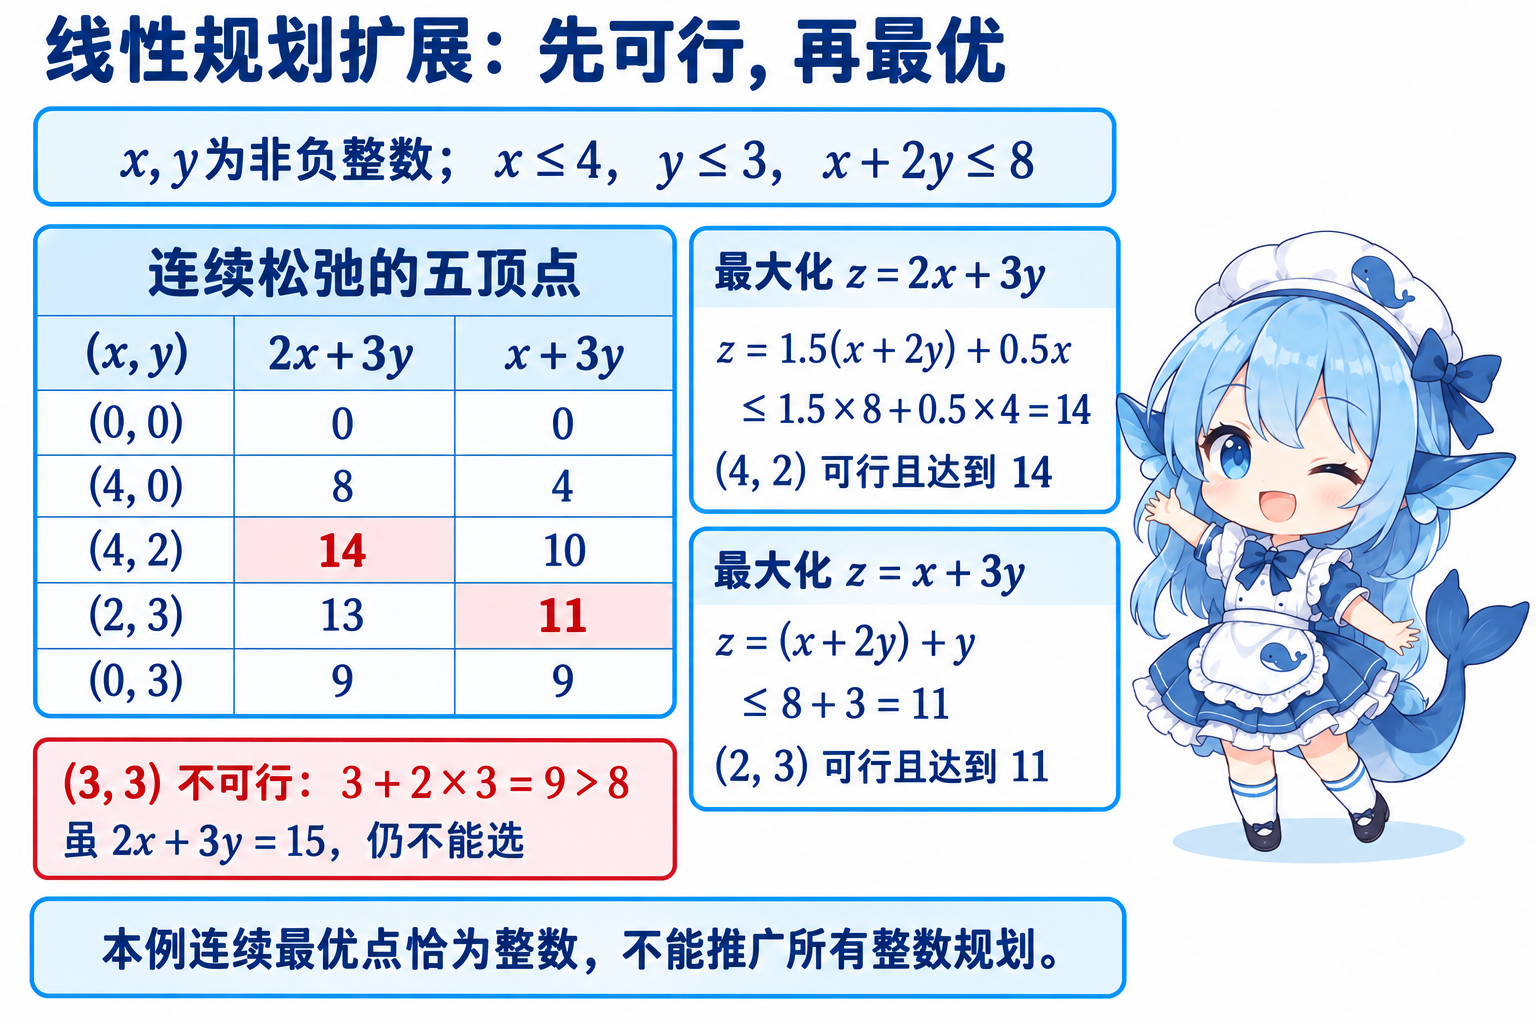
第二种证明直接用约束:z=1.5(x+2y)+0.5x≤1.5×8+0.5×4=14;(4,2)满足全部条件并取到14,所以最优。点(3,3)虽然算出z=15,却有 3+2×3=9>8,不可行。只有“目标值最大”而不检验约束,会选到不存在的方案。
只换目标为 z=x+3y,约束不变,则 z=(x+2y)+y≤8+3=11;(2,3)可行且达到11。原目标等值线斜率−2/3,新目标为−1/3,更平;变化的是目标权重,不能沿用原(4,2)答案。取到上界的可行点给出了证明,不要求看到第一个角点就宣布唯一解。
再恢复目标 2x+3y,只把约束改为 x+2y≤7。连续可行域五点变为 (0,0)/(4,0)/(4,1.5)/(1,3)/(0,3),连续最优在(4,1.5),z=12.5。y=1.5不满足整数约束,不能直接交这个方案;将y向下取整到(4,1)虽可行,目标只有11。
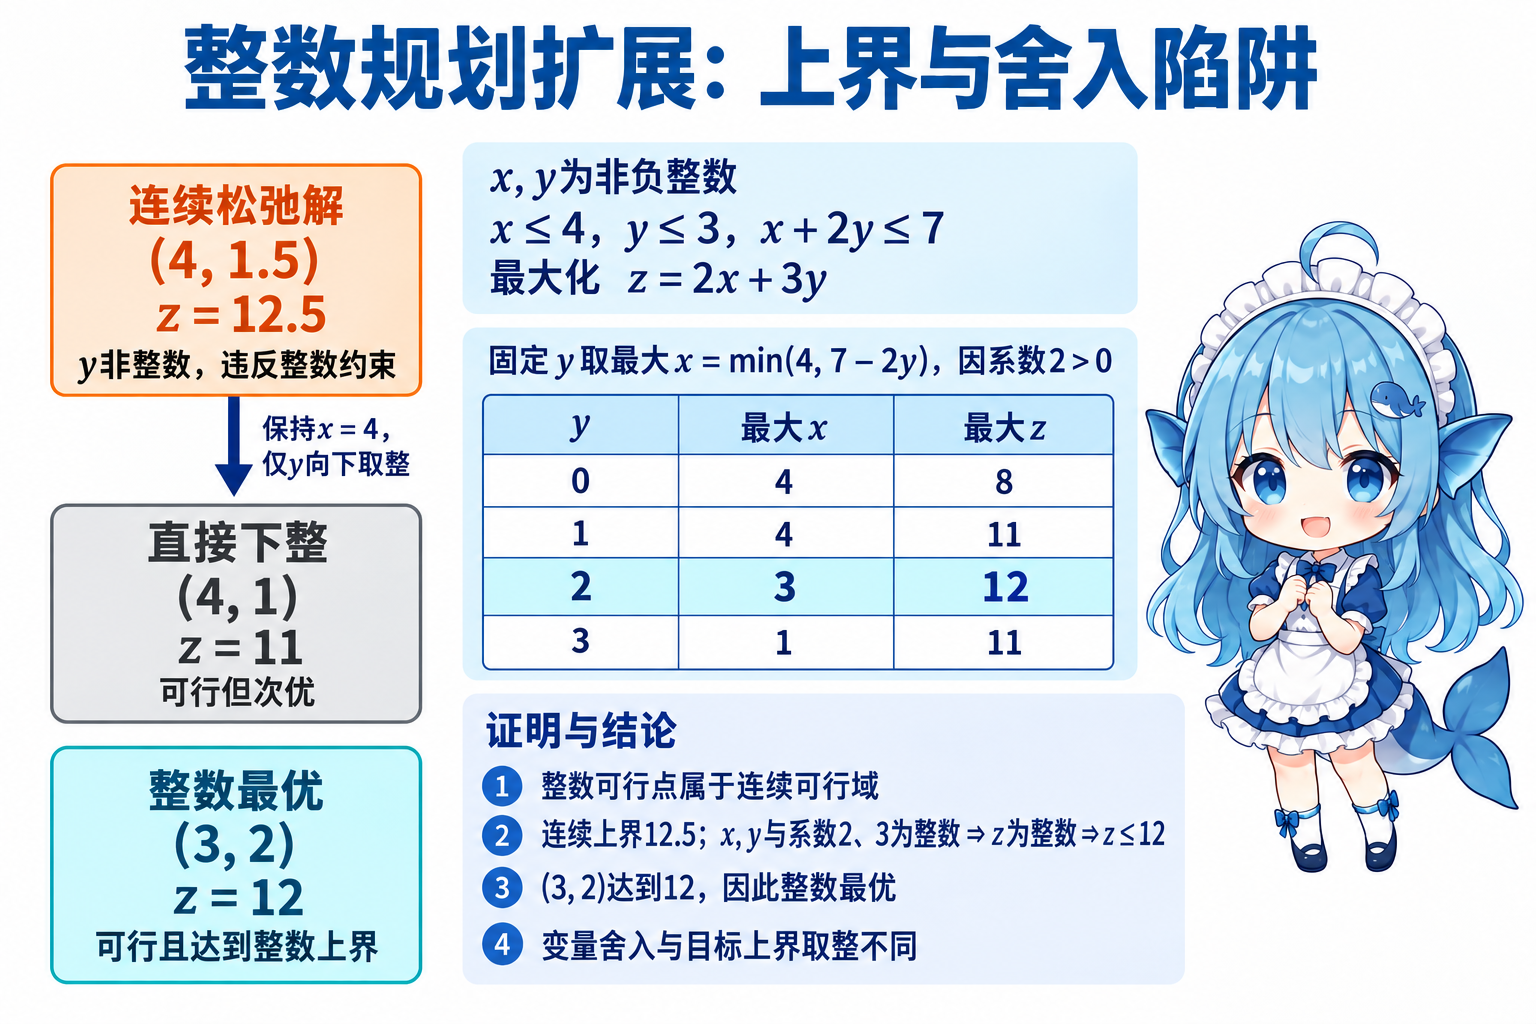
| 整数y | 合法最大x | 该行最大z=2x+3y |
|---|---|---|
| 0 | 4 | 8 |
| 1 | 4 | 11 |
| 2 | 3 | 12 |
| 3 | 1 | 11 |
完整枚举 y 的0–3四种可能,每行取合法最大 x 是因为目标中 x 的系数为正,故整数最优为 (3,2)、z=12。另一证明:连续最优12.5是整数问题的上界,而 2x+3y 在整数x/y下只能是整数,所以 z≤⌊12.5⌋=12;(3,2)达到12。这是对目标上界取整,不是随手舍入连续解的变量。更多变量时可用其它优化方法,本例四行枚举足够,没有“每个整数最优必是原连续边界交点”的通用规则。
回到预约服务,先说出评价对象、请求边界和负载,再比较完成同一工作的时间。资源条件决定能否重叠,原新分母决定怎样计算局部收益,测量与评估规则决定分数支持什么结论。读到新题时,把这些条件写清,公式才有确定的含义。