预约请求已经抵达服务器,程序准备检查时段。主存里有运行所需的代码与数据,网卡还能收到新的请求,CPU 要继续执行下一条指令。把镜头停在这台机器上:谁保存地址,谁计算结果,谁在搬数据?回答这些问题,比先背一排芯片名称更容易看清硬件的约束。本节先看单机内部,跨机寻址与路由在 2.5 继续展开。
2.2.1 五种功能,怎样落到真实部件上
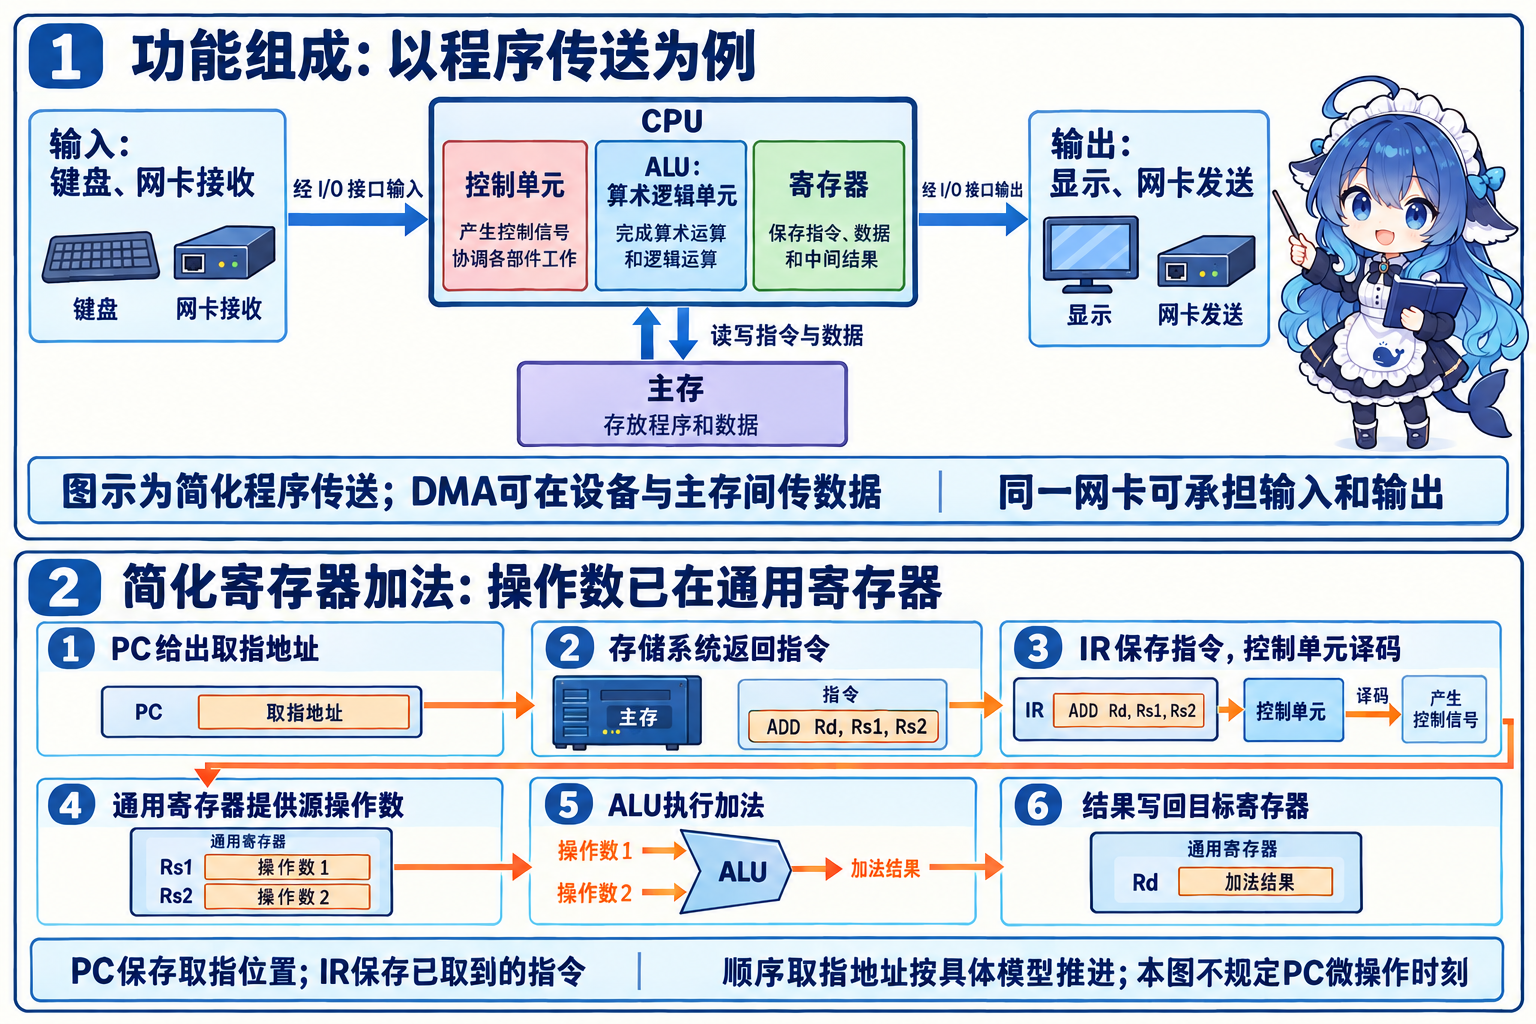
冯·诺依曼计算机的经典功能划分是运算、控制、存储、输入和输出。CPU(Central Processing Unit,中央处理器)把运算与控制等功能结合起来,还需要寄存器保存执行中的状态。现代处理器可继续集成缓存、内存控制器等部件;五功能模型没有规定必须分装成五颗芯片。
“存储器”按保存信息的功能包含主存和外存;“外部设备”按与计算机主体连接的角色也包含磁盘等外存。一块网卡在接收时承担输入,在发送时承担输出。先确定功能、连接角色还是封装范围,几种描述就能同时使用。

2.2.2 从 PC 找到指令,再按指令改变状态
预约程序要比较两个时段。用简化处理器说明:PC(Program Counter,程序计数器)提供取指位置;存储系统返回指令,IR(Instruction Register,指令寄存器)保存当前指令,译码部件解释操作并产生控制信号。寄存器提供操作数,ALU(Arithmetic Logic Unit,算术逻辑单元)完成算术或逻辑运算,结果按指令写回,再更新 PC。跳转会改变下一取指位置。
若是 Load,处理器计算有效地址,存储系统取得数据后写入目标寄存器;Store 则把寄存器里的数据送到指定存储位置。有效地址可能还需要地址转换,不能直接把 ALU 算出的地址一律称为物理地址。寄存器加法本身不必再读写主存;现代内部也可能重命名、乱序和推测执行。图里的顺序流程用于解释职责,程序可见的结果仍须符合相应指令集的约定。
教程图 2-3 还把指令部件、运算部件、存取部件和完成部件分开描述:控制信号安排取数和运算,结果交完成部件排队、反馈执行情况,再影响后续顺序或跳转。它是一种部件关系示意,不要求把所有方框依次走一遍。教程还从位宽演化、集成能力、单核/多核/异构多核/众核观察处理器;这些描述与指令集类型可以同时成立。
单核只有一个处理核心;多核把多个核心用于并发工作;异构多核强调核心能力或职责不同,例如不同性能/能耗的核心配合;众核强调大量核心的组织。核数增加能否缩短同一任务,仍看可并行部分、同步和访存。位宽则描述相应的数据处理等架构能力,不能据“64位CPU”直接断定所有物理地址线、数据通路和接口均为64位。

ISA(Instruction Set Architecture,指令集架构)规定软件可见的指令、寄存器、数据表示和寻址等约定。微架构描述流水线、执行单元、缓存怎样实现这些约定。两款处理器支持同一 ISA,仍可有不同频率、流水深度和平均 CPI;它们不能仅凭“能执行相同程序”判断性能相同。
| 讨论的问题 | 典型线索 | 成立范围 |
|---|---|---|
| CISC 与 RISC:指令体系的设计倾向 | 教材用 x86 举 CISC、ARM 和 Power 举 RISC。经典 RISC 倾向较规整格式、Load/Store 和较多寄存器;经典 CISC 允许较复杂指令和寻址。 | “一般采用微程序/硬布线”“常用定长”是经典比较口径。现代 x86 也使用流水;RISC-V 可有压缩指令扩展。类别不保证单周期或必然更快。 |
| 规格开放与实现授权 | RISC-V 是开放的 ISA;ARM 采用相应 IP 授权模式。 | 开放 ISA 可以有专有核心实现。ISA、核心 RTL 和整颗芯片分别判断,不能由一种开放性推出全部开放。 |
| 指令与数据的存储路径 | 传统冯·诺依曼模型统一存储;传统哈佛模型分开指令与数据存储及通路。 | 共享单路径才出现相应资源冲突。统一主存加分离 I-Cache/D-Cache 可同时成立,不能仅凭 CPU 品牌判所有层次。 |
任务又决定了部件侧重。CPU 适合组织复杂控制流;GPU(Graphics Processing Unit,图形处理器)利用大量并行执行资源处理适合的数据并行任务;DSP(Digital Signal Processor,数字信号处理器)常用乘累加、饱和运算、循环和专门寻址支持滤波等信号处理。FPGA(Field-Programmable Gate Array,现场可编程门阵列)用配置形成可重构电路,ASIC(Application-Specific Integrated Circuit,专用集成电路)针对用途设计电路。可编程 FPGA 也可以包含硬核或软核 CPU。
SoC(System on Chip,片上系统)描述系统功能的集成,可包含 CPU、GPU、DSP、专用加速器和控制器。GPU/FPGA/ASIC 是常见 AI 加速实现的讨论口径,SoC 是另一观察轴;CPU 和 DSP 也能参与 AI 工作负载。工程选择还要看任务、软件生态、数据搬运、开发与量产成本,不能固定宣布某类始终省电、便宜或更快。教程列举龙芯、飞腾、申威、兆芯等国产处理器作为例子,本册不把历史举例当作当前市场排名。
频率给出每秒的拍数,CPI 给出这批程序花了多少拍
例题求一批教学程序的 CPU 时间及指令速率。动态执行 1,000,000 条指令,频率 2 GHz;三类指令的条数占比为 60%、30%、10%,各类 CPI 为 1、2、4。CPI(Cycles Per Instruction)是周期数除以指令数,本例给定的 CPI 已包含需计的硬件停顿;不再重复加这些成本,也不计程序挂起等待外部 I/O 的时间。
平均 CPI = Σ(条数占比 × 各类 CPI) = 0.6×1 + 0.3×2 + 0.1×4 = 1.6 周期/指令。换成实际条数,各类分别花 600,000、600,000、400,000 周期,总共 1,600,000 周期。频率 f=2×10⁹ 周期/s,周期时长 1/f=0.5 ns,所以 T_CPU = 指令数 N × 平均 CPI / f = 1,600,000/(2×10⁹) s = 0.0008 s = 0.8 ms。
MIPS(Million Instructions Per Second)表示每秒百万条指令:MIPS = N/(T_CPU×10⁶) = 1250。若同一批程序明确完成 400,000 次浮点操作,MFLOPS = 浮点操作数/(T_CPU×10⁶) = 500。浮点操作数由题设给定;一条乘加指令按定义可能计两次运算,不能把浮点指令条数直接当操作数。MIPS 的指令与 MFLOPS 的操作也不互相换用。
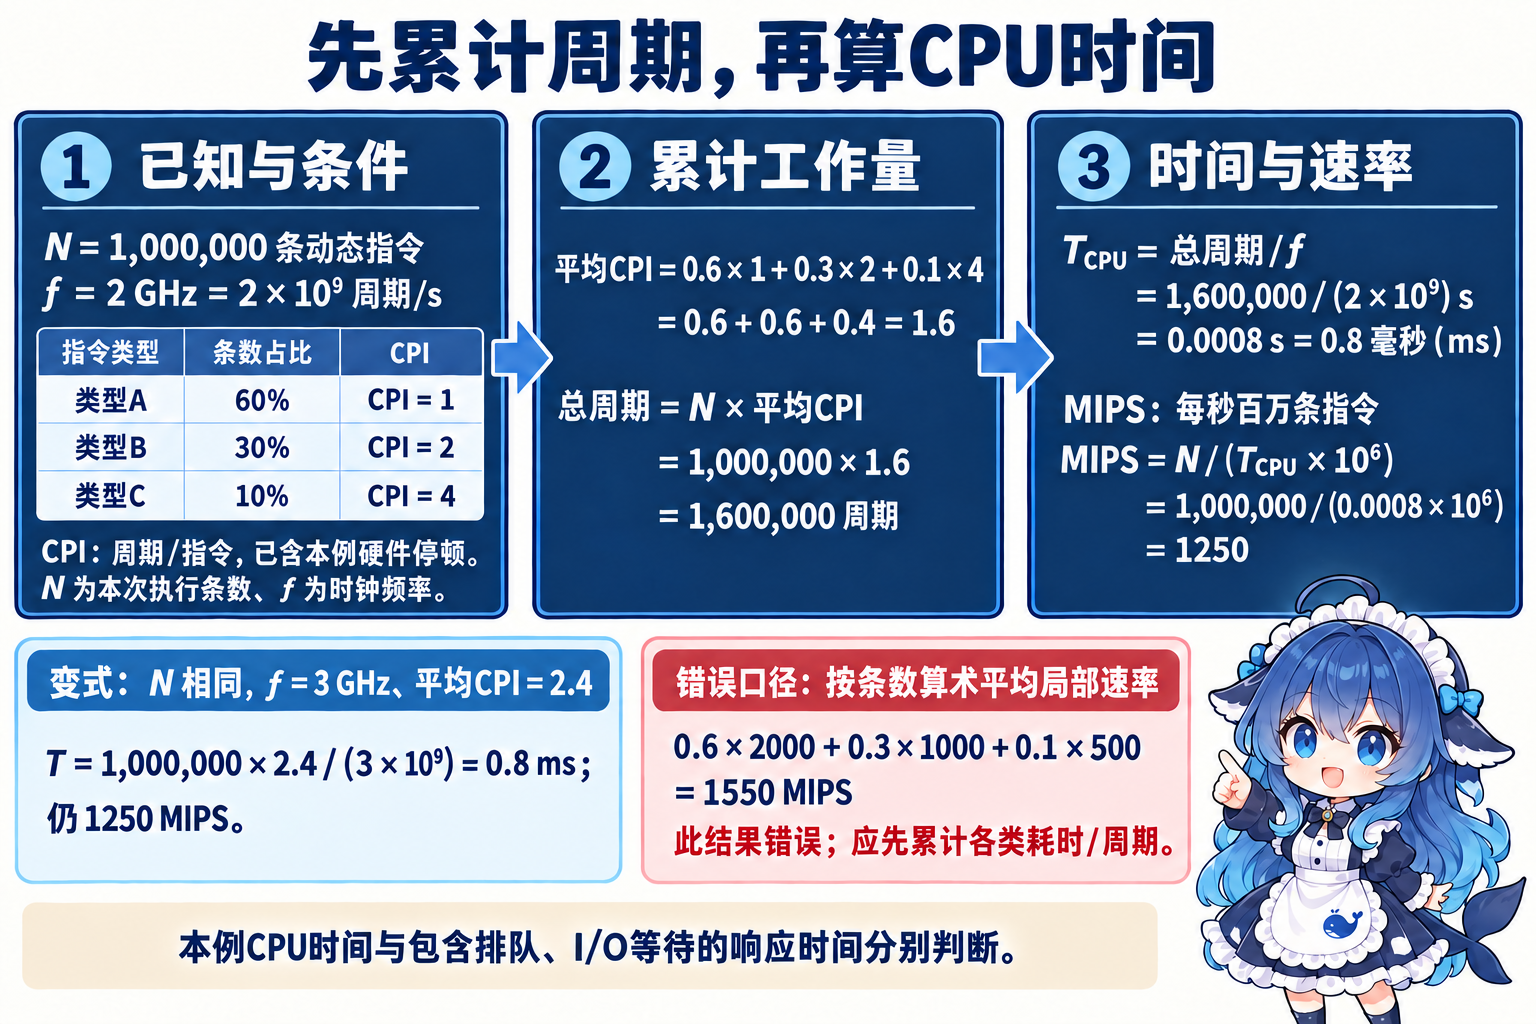
改变一个条件:频率提升到 3 GHz,同程序平均 CPI 变成 2.4。总周期为 2,400,000,时间仍是 2,400,000/(3×10⁹)=0.8 ms,MIPS 仍为 1250。频率比值不能单独当程序加速比;若编译器改变动态指令数,还要重新计 N。
误用检查:把三类单独速率 2000、1000、500 MIPS 按指令条数权重算术平均,会得 1550 MIPS。各类一条指令花的时间不同,应先合计周期,或按相同条数权重取速率的调和平均。CPI 是“周期/指令”,IPC 是“指令/周期”;口径相同时二者互为倒数。多发射实现的 CPI 可以小于 1。CPU 时间可以包含正在运行时的硬件等待,端到端响应还可能包含排队、网络与进程挂起。
第一项走完需要多久,后续两项相隔多久
流水线让不同任务在不同阶段交叠。题设给出四个专用阶段耗时 2、1、5、4 ns,连续处理 100 个独立同路径任务,无资源冲突、分支、额外停顿和阶段寄存器开销。最慢阶段只能每 5 ns 处理一项,限制稳态输出间隔。首项仍须经过全部阶段。
模型 A明确各段完成后即可转交、有所需缓冲。选每 5 ns 投入一项的调度:首项在 0 ns 进入,依次于 2、3、8、12 ns 完成各段,首项延迟 L=Σtᵢ=12 ns;下一项在 5 ns 进入、17 ns 输出。因此 T=L+(n−1)Δ=12+99×5=507 ns,其中 n 是任务数,Δ 是稳态输出间隔。若更快投料,瓶颈前会排队,不能画成所有任务均无等待却每 2 ns 输出。
模型 B采用共同 5 ns 时钟,每阶段占一个整拍。首项经历 0–5、5–10、10–15、15–20 ns 四拍,延迟为 kΔ=20 ns;之后每拍完成一项。T=(k+n−1)Δ=(4+100−1)×5=515 ns。k 表示阶段数。快阶段的剩余时间不能在这个模型里让任务提前越过时钟边界。
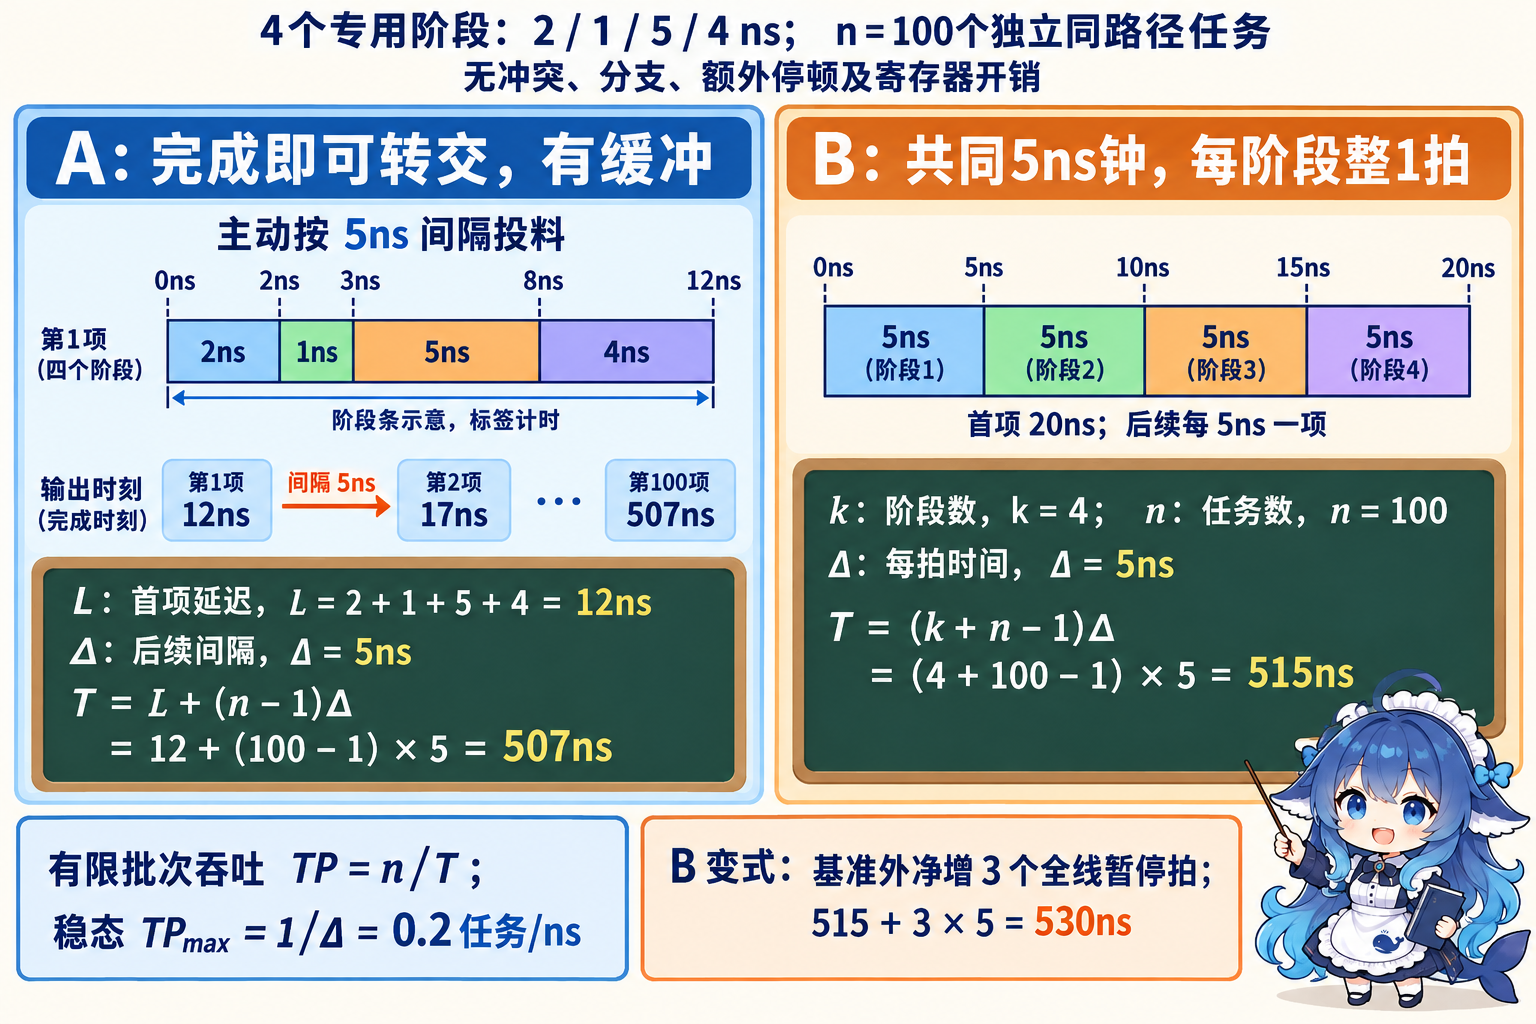
有限批次吞吐率是 TP=n/T,A 为 100/507≈0.1972 任务/ns,B 为 100/515≈0.1942 任务/ns;理想长批次极限为 TP_max=1/Δ=0.2 任务/ns。这没有说一项 5 ns 就能走完整条线。首项装填使有限批次平均吞吐率低于稳态极限。
变式在模型 B 的基准调度外、批次完成前,新增 3 个全流水线暂停拍,净延长三拍:515+3×5=530 ns。局部等待可能被其它活动隐藏,单数“没有输出的拍”还会把原有装填期算进去。公式中的额外停顿必须指真正延长完成时间的部分。
边界与基准:不流水的串行基准若明确为 100×(2+1+5+4)=1200 ns,A 的加速比为 1200/507≈2.3669。n=1 时 A 耗时 12 ns,没有批次加速;B 对同一 12 ns 基准反而需 20 ns。比较时要说明基准。若只把 5 ns 阶段拆为 2 ns 和 3 ns,原来 4 ns 阶段会成为瓶颈,不能说新节拍是 2 ns。阶段寄存器及通信开销重新出现时也须计入。
真实指令还会遇到结构相关(抢同一资源)、数据相关(等待前序结果)、控制相关(分支方向尚未确定)。转发可提前提供已经产生的结果,资源复制可缓解某些结构冲突,预测可减少某些控制等待;它们各有适用条件,不保证所有停顿消失。传统统一单路径存储的取指与访数冲突,可由分开路径缓解,这与把整个主存划成互斥的两类是不同问题。
2.2.3 把存储的角色、介质与检索方式分开
代码和预约表为何放在主存,还需要 Cache?程序往往近期重复访问同一地址,或接着访问相邻地址。前者叫时间局部性,后者叫空间局部性。遍历数组时循环计数变量会重复使用,数组连续元素会接连被访问。有限而快的缓存因此有机会满足大量访问,存储层次才具有实用价值。命中率仍取决于工作集、访问顺序、映射和容量,局部性不保证任何程序都达到固定百分比。
| 观察轴 | 主要类别和机制 | 易混条件 |
|---|---|---|
| 在系统里承担什么角色 | 寄存器保存执行状态;Cache 缓存数据或指令块;主存容纳运行所需信息;外存长期保存文件等。 | L1/L2/L3 表示缓存层级,位置与实现依设计。教程片上/片外、容量范围和保存年限为历史示例,不作今天的通用上限。 |
| 用什么介质实现 | SRAM 通常用于缓存,无需周期刷新;DRAM 通常用于主存,需要刷新,两者通常易失。Flash 通常块擦除、非易失;NOR 常用于可原位执行的固件,NAND 常用于大容量存储。 | “静态”不表示掉电保持。Flash 可替代特定固件 ROM 或外存用途,不能在常规主存模型下当作同样高速、可原位随机改写的 DRAM。 |
| 怎样找到信息 | RAM 按地址随机存取,不必从头扫描;SAM 如磁带顺序访问;DAM 如机械磁盘先定位区域再等待相应位置;CAM 用内容关键字比较检索。 | RAM 的实际访问时延未必每次相同。CAM 是检索机制;DMA 是传送控制方式,两者缩写相近但对象不同。 |
EPROM 是可擦可编程 ROM 的历史类型,典型器件用紫外线擦除;EEPROM 可电擦写,Flash 是相关的非易失存储技术,具体编程和擦除粒度依器件。NVRAM 强调非易失的随机访问存储,可有不同实现,不能凭名称推断一定采用某种芯片。磁盘、磁带、光盘等介质也各有访问和保存条件;本册不把原教程给出的保存年限当保修承诺。
教程按与处理器核心的物理距离展开四层:核心内直接集成的缓存、核心外经互连访问的缓存、独立主存,以及磁盘/Flash等外存。缓存两层的教材典型实现均为SRAM,主存典型为DRAM;L1/L2或L2/L3的对应可随设计变化。“核心外”仍可能在同一芯片内,片外一词在这里不能直接扩大为整个处理器封装外。寄存器是更贴近执行状态的部件,页式虚拟存储则是地址与驻留管理机制,不能加作这四层后的第五种物理存储芯片。
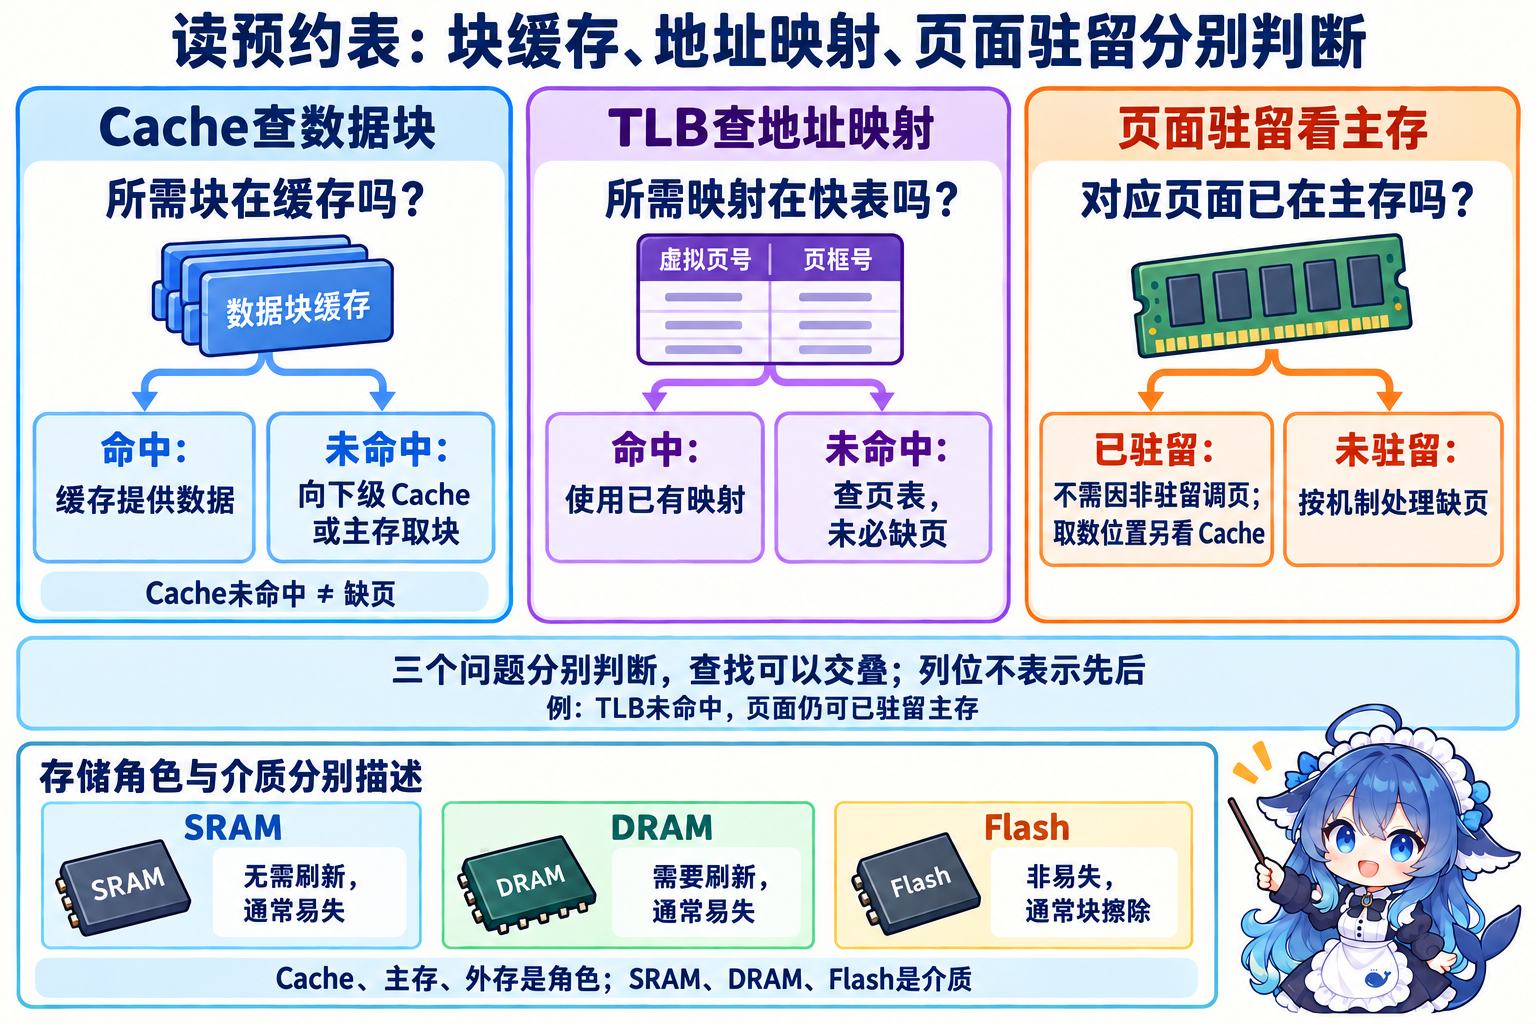
缓存硬件要判断某行是否保存目标块,通常比较有效位和 Tag。直接映射让主存块落到固定行;全相联可放任意行;组相联让块落到固定组、在组内选一行。限制越少,需要考虑的候选位置及比较资源通常越多。直接映射中两个常用块落同一行会互相替换;组相联增加组内选择可以缓解这种冲突,但容量和访问成本仍有限。
常规 Cache 查找与块映射由硬件执行,微程序主要讨论处理器控制实现;OS 则负责虚拟地址映射和页面管理。MMU(Memory Management Unit)参与虚拟地址到物理地址的转换,TLB(Translation Lookaside Buffer)缓存地址转换信息。TLB 没找到映射可继续查页表,页表对应页面已驻留时,无需因该页非驻留而调页;Cache 没找到数据块也可以直接从更低缓存或主存取块。缺页处理的责任及地址变换,在 2.3.2 存储管理继续展开。

MPU(Memory Protection Unit)侧重区域访问权限保护,不能直接替代页式 MMU 的地址映射。Cortex-M3 是无 MMU、可选 MPU 的具体教材例子;不要由此断言整个处理器家族都一样,或把“Linux”所有配置一概限定为必须有 MMU。讨论普通分页多进程环境与特定无 MMU 配置,要说明是哪种运行模型。
写直达(Write-Through)更新缓存时也向下层传送写入;写回(Write-Back)可先更新缓存并标脏,之后按替换或维护要求写出。写缓冲、一致性和持久化另有条件。脏块换出会增加成本,不能把所有读写平均时间都套单级只读公式。硬件自动查找也不表示系统软件无法配置缓存属性或执行维护操作。
先问未命中的时间从哪里起算
例题求单级 Cache 的平均读访问时间。命中率 h=90%=0.9,命中总耗时 t_h=2 ns;未命中从开始查 Cache 到取得数据的总耗时 t_m=42 ns。不计写回、预取或并行重叠。按 100 次访问看,90 次花 2 ns,10 次花 42 ns:总耗时=90×2+10×42=600 ns,平均 T=h t_h+(1−h)t_m=600/100=6 ns。
同一机制也可写成:每次查 Cache 花 2 ns,未命中在此基础上追加 P=40 ns,于是 T=t_h+(1−h)P=2+0.1×40=6 ns。这里 t_m=t_h+P=42 ns,42 与 40 是不同量。将 42 ns 当追加罚时再加 2 ns,会误算 6.2 ns。
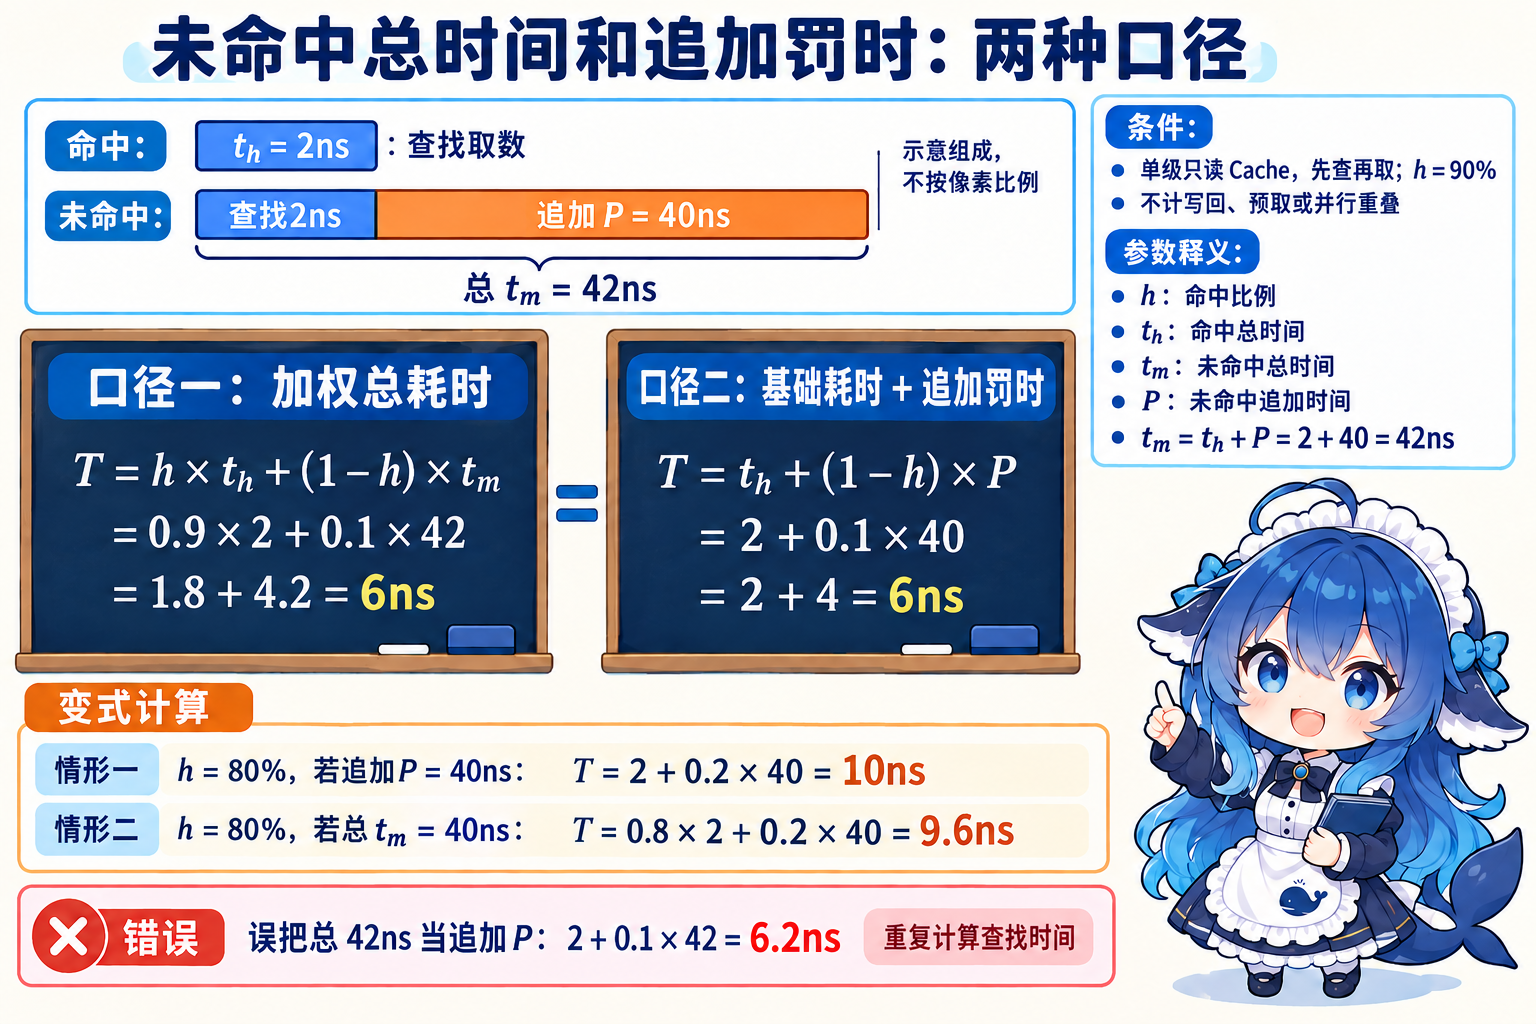
变式命中率降到 80%、追加仍为 40 ns,T=2+0.2×40=10 ns。如果题设改为“未命中总耗时40 ns”,则 T=0.8×2+0.2×40=9.6 ns。主例 h=1 时为 2 ns,h=0 时为 42 ns,结果须在这两个端点之间;10 ns 不表示一次访问一定花 10 ns,它是给定比例下的平均值。
地址决定有多少单元,编址粒度决定每单元多大
例题按字节编址,范围为 B0000H–DFFFFH,含首尾,用 64 Ki×4 bit芯片组成。H 表示十六进制;Ki 表示 2¹⁰=1024。先求地址单元数:M=DFFFFH−B0000H+1=E0000H−B0000H=30000H,即 3×16⁴=3×65,536=196,608=192 Ki 个地址。每地址 8 bit,容量为 192 KiB。
每片有 64 Ki 个地址、每地址 4 bit,容量 64 Ki×4 bit/8=32 KiB。深度需要 M/64 Ki=3 个地址组,这叫字扩展;宽度需要 8/4=2 片并联拼成每地址 8 bit,这叫位扩展。两方向相乘:N=(M/d)×(W/w)=3×2=6 片,其中 d 是单片地址数、w 是单片位宽,W 是目标每地址位宽。回代 6×64 Ki×4 bit=192 Ki×8 bit,与目标容量一致。
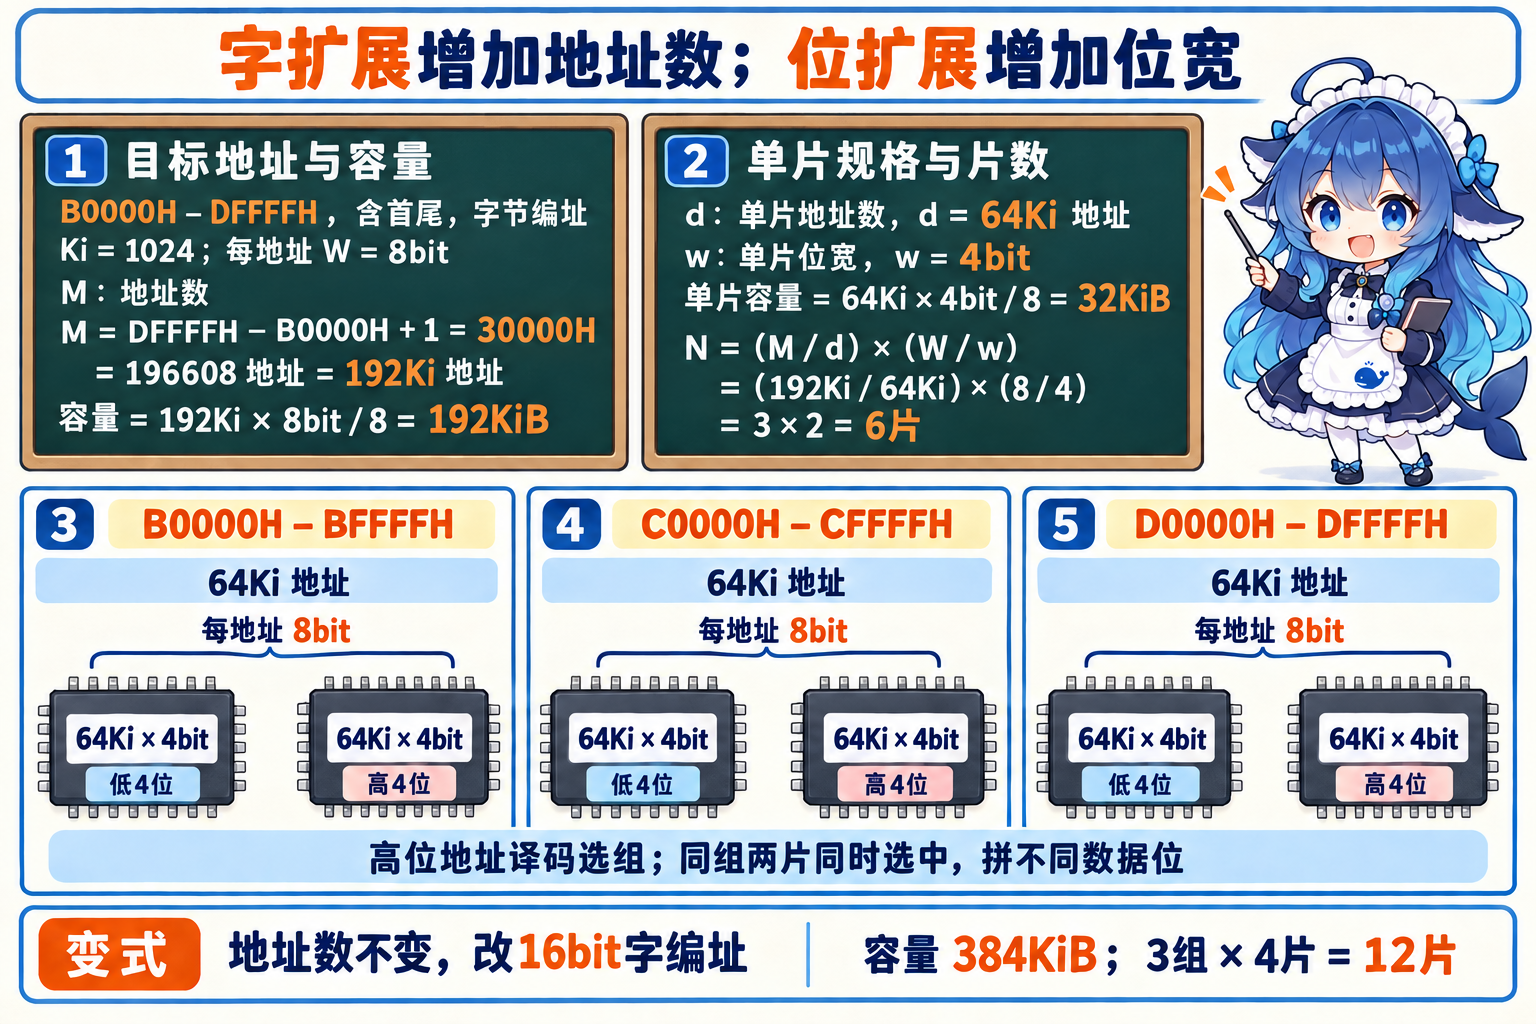
变式保持同一地址范围,改为每地址 16 bit。仍有 192 Ki 个地址,每地址 2 B,总容量 384 KiB;每组需要 4 片,3 组共 12 片。地址数不变,字节容量与位扩展数量改变。
误用与逆查:10000H=16⁴=65,536=64 Ki,不能记成 32 Ki;闭区间不能漏掉 +1。8 片 32 Ki×4 bit 的总容量为 128 KiB,字节编址、首地址 80000H 时,末地址为 80000H+20000H−1=9FFFFH。若 21 位地址、每地址 32 bit,容量为 2²¹×4 B=8 MiB;仅知道数据总线宽度,不能直接推断每地址多少字节。
盘数相同,冗余布局改变有效容量与故障条件
预约记录保存到磁盘后,希望一块盘失效时仍能读到它。RAID(Redundant Array of Independent Disks,独立磁盘冗余阵列)可用条带、镜像或校验组织多盘,既有硬件也有软件实现。以下自编例统一用 6 块同为 2 TB 的盘,TB=10¹² B,全部为活动盘;忽略元数据、格式化和保留空间。容错结论还假设其余数据完整可读、镜像已同步,无其它失效。
| 固定布局 | 容量推导 | 失效条件 |
|---|---|---|
| RAID 0:纯条带 | N C=6×2=12 TB | 没有磁盘失效冗余。坏盘会破坏完整逻辑数据集,不表示其它盘每一个比特都消失。 |
| RAID 1:六盘同一镜像组 | 六份相同内容,有效 C=2 TB | 至少一份完整同步镜像仍可读,数据集才能完整保存。不能把这个组套 N/2×C。 |
| RAID 5:分布单校验 | (N−1)C=5×2=10 TB | 任一 1 块活动盘失效;校验等价占一盘容量,非固定一盘专做校验。 |
| RAID 6:分布双校验 | (N−2)C=4×2=8 TB | 任意 2 块活动盘失效,在本教学假设下仍可恢复全部数据。 |
| RAID 10:三对两盘镜像,再条带 | (N/2)C=3×2=6 TB | 保证任一 1 盘失效;更多失效看镜像对,每对须至少保留一份。 |
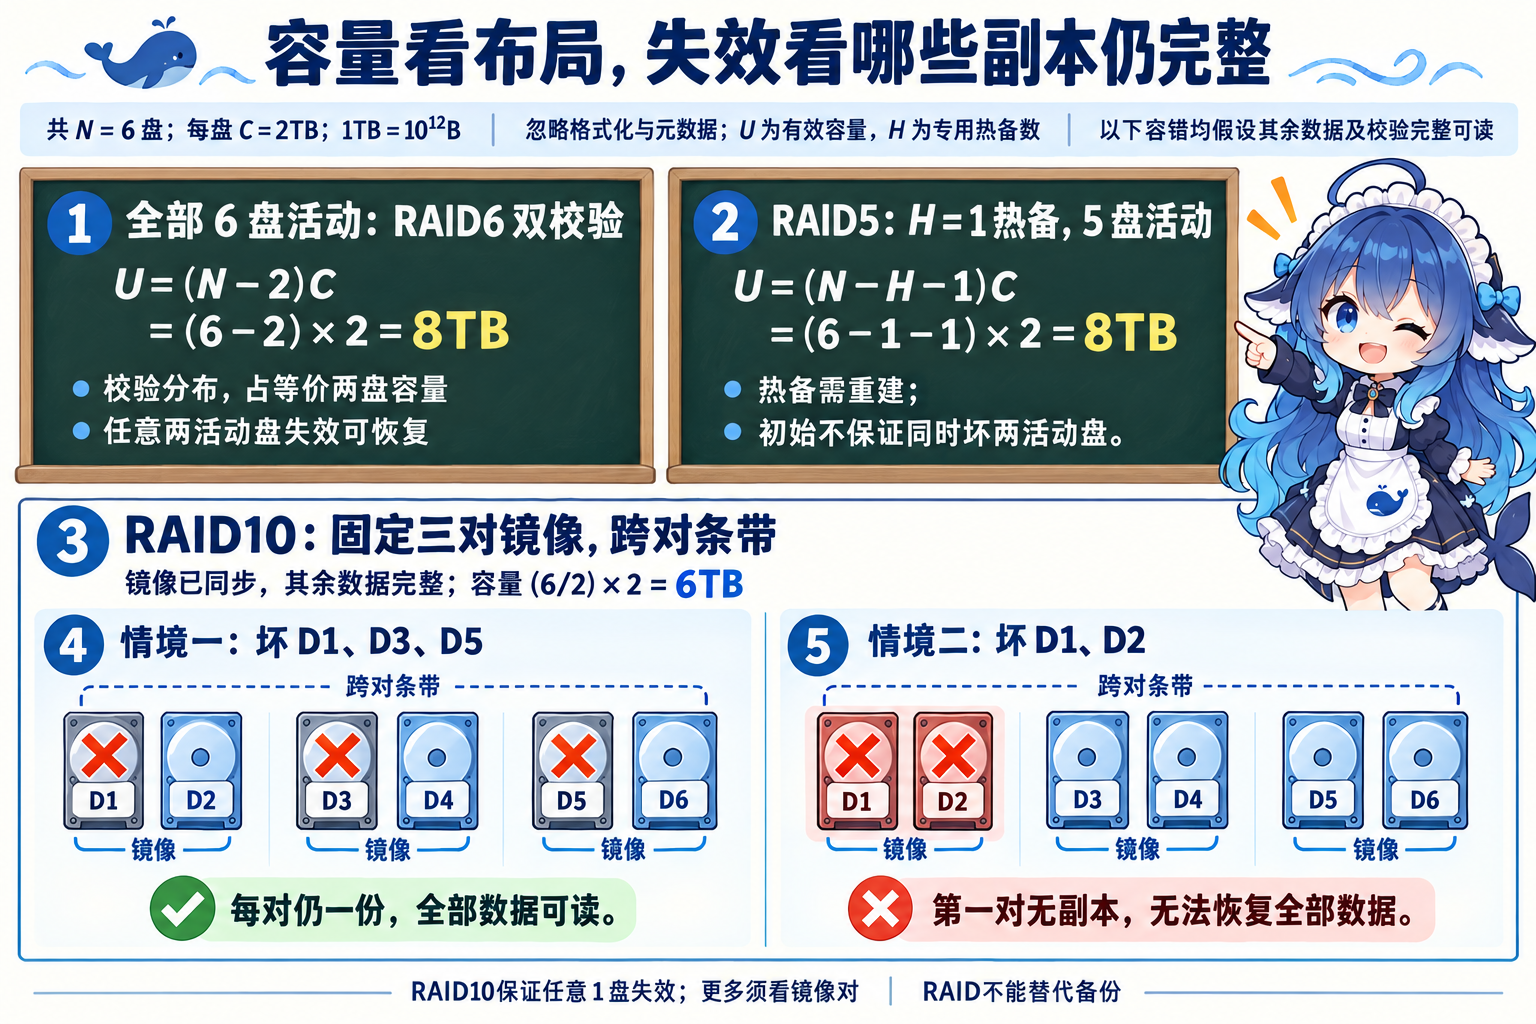
完整容量计算可以反向检查:RAID 6 的 8 TB 数据加等价 4 TB 校验,正好是 12 TB 原始容量。变式把 6 盘中的 1 盘专作热备,余下 5 盘活动 RAID 5:(N−H−1)C=(6−1−1)×2=8 TB,H 是不参与当前条带的热备数。热备要经过重建才得到替代数据,重建前没有立即提高到“任意同时坏两块活动盘仍可恢复”。
三对镜像设为 (D1,D2)、(D3,D4)、(D5,D6)。坏 D1、D3、D5 时各对还有伙伴;仅坏 D1、D2 却已失去第一对的两份数据。不能把“最多在特定分布下坏 3 盘”改成“任意 3 盘”,也不能把“保证任意 1 盘”改成“最多只能坏 1 盘”。RAID 01 先把盘条带成两个组再镜像,首盘失败会使相应条带组不完整,第二盘的危险位置与 RAID 10 不同。
另一个容量变式:活动盘 60、80、80、80 TB,另有 100 TB 热备。常规等长条带 RAID 6 每盘参与容量由最小活动盘 60 TB 限定,(4−2)×60=120 TB;热备不加入活动盘数或最小值。特殊分组及自动扩容布局须另算。旧题提到 RAID 3 时,注意其专用校验盘与 RAID 5 分布校验的区别;RAID 2 的海明校验需明确数据位与校验位组织,本节不采用旧笔记的通用简化片数公式。
RAID 维持的是给定磁盘失效条件下的信息冗余。误删可以同步到镜像,仍需要备份和恢复措施。读写性能还取决于块大小、顺序/随机负载、控制器、缓存和重建状态,不凭级别数字给绝对速度排名。可用性与恢复时间在 2.9 性能另讲。
2.2.4 数据怎样经过互连,谁获得传送机会
CPU、主存与 I/O 控制器之间需要约定传送格式和控制逻辑,这就是总线讨论的对象。教程按位置分内总线(片内/片上)、系统总线和外部总线(通信总线):分别看芯片内模块,计算机内 CPU、主存与 I/O 接口等,以及板与外设或系统间的互连。广义系统总线还涉及级联的局部总线,名称应结合教材和具体拓扑。桥用于衔接不同总线协议等条件。
再问位怎样经过线路,才得到并行与串行。PCI、PATA 是典型并行示例;PCIe、SATA、USB、CAN、RS-232/RS-485、串行 RapidIO 和以太网是相应串行通信示例。PCIe 一条 lane 内串行传位,多 lane 聚合仍保持这一性质。原教程把 PCIe 放入“并行”列表,此处按 PCI-SIG 官方定义校正。不要仅凭名字里的一个字母判所有缩写;RapidIO 等名称也须看具体版本。ARINC 与 MIL-STD-1553 等表示专业领域的互连规范,不是第四种位置分类。

经典系统总线模型还按功能看地址、数据和控制。AB(Address Bus)指定位置,DB(Data Bus)承载内容,CB(Control Bus)协调读写、就绪与请求。CPU 访问内存时是主设备,DMA 传送时主设备可能换成 DMA 引擎;方向要以当前主设备判断。控制信号有发往外部的命令,也有返回的状态,不能据“整体双向”推断每根线都双向。
在传统共享驱动总线上,同一时刻通常只允许一个发送者驱动数据线,多接收者可以监听同一传送。多个主设备申请时需要仲裁。链式查询把授权逐个传递,线少、位置影响优先级、链路故障会影响后继;计数器查询可以从固定或循环起点查询;独立请求有各设备的请求/授权线,便于集中判优但专线更多。线数统计要先说明是否计忙信号、共享地址线。此共享模型不能直接替代点对点全双工链路或开漏线的仲裁规则。
带宽有每秒的单位,地址空间没有
例题求理想连续传输的带宽:并行数据宽 W=64 bit、频率 f=100 MHz=100×10⁶ 周期/s、每拍 m=1 次传送,无仲裁、编码等损失。一次传 W/8=8 B,所以 B=(W/8)fm=8×100×10⁶×1=800×10⁶ B/s=800 MB/s。这里 MB 用十进制;每拍 10 ns,8 B/10 ns 也得到同一速率。
变式每拍传 2 次,理论带宽为 1600 MB/s;如果仅 75% 时间在传有效数据,平均有效带宽为 1600×0.75=1200 MB/s。频率仍是 100 MHz,改变的是 m。传 625 MiB 数据若仍用 800 MB/s 理想链路,先换量:625×2²⁰=655,360,000 B,再求 T=数据量/速率=655,360,000/(800×10⁶)=0.8192 s,不取整。
误用与边界:64 bit 不能当 64 B;不能把双向合计带宽当一次单向传输能力。28 位地址线、字节编址给出 2²⁸ B=256 MiB 可寻址空间,描述的是能区分多少位置,不是每秒传多快。带宽、一次传送时延、时延变化的抖动与 QoS 服务约束分别判断;高带宽也不保证每个请求低延迟。
2.2.5 接得上,还要知道怎样通信
总线与接口不是一一对应:一种传输规范可以有多种连接形态,接口还规定两边如何交互。以固态盘为例,M.2 说明形态与键位等条件;具体设备和插槽可能支持 SATA 或 PCIe;NVMe(Non-Volatile Memory Express)定义非易失存储命令和队列等接口,常经 PCIe 连接。同样的外形不能保证三层都匹配。

| 连接任务 | 教材常见名称 | 继续核对什么 |
|---|---|---|
| 联网 | 常称 RJ45 的以太网 8P8C 电口、相应光纤连接/模块接口 | 接头、介质、速率和物理层匹配。网络接口用途与底层连接形态分开。 |
| 存储 | SATA、SAS、PCIe 等及相应接头 | 链路和存储命令支持;SATA 名称还包含协议及连接规范,不能只看一个插孔。 |
| 显示与音频 | HDMI、DVI、DisplayPort;TRS、RCA、XLR 等 | 所支持的信号、转换和具体能力,模拟/数字及输入/输出另判。 |
| 通用与控制 | USB、PS/2、LPT、RS-232、RS-485 等 | USB-C 形态不保证所有速率、视频和供电能力;RS-232 也可用于设备配置接口。 |
| 特定信号接入 | 离散量接口、A/D 转换接口等 | 输入电平、采样需求、转换位置与设备条件;可能按需求专门设计。 |
接口控制还涉及两个可以同时回答的问题:怎样知道设备就绪,数据由谁搬运?轮询由 CPU 查状态;忙等的教学模型会占用准备期。中断让 CPU 在等待期间做其它工作,就绪后处理通知;传统程序传送仍由 CPU 执行指令搬数据。DMA(Direct Memory Access)由硬件在设备与主存间搬数据块,CPU 仍要配置和收尾,可能与 DMA 争用内存互连。通道是能执行通道程序的专用 I/O 处理机,组织一组 I/O 操作。

教材常见“查询占 CPU 最多,通道最少”比较的是同样 I/O 负载下相应控制模型。中断准备通知和 DMA 数据搬运经常同时存在,不能把它们都当互斥选项。周期窃取描述 DMA 获得传送机会对 CPU 访存的影响,不等同执行中断服务程序保存现场;也不表示 DMA 对 CPU 速度从无影响。
2.2.6 把信号方向落到主机连接处
预约返回平板,平板播放确认声。数字音频经 DAC(Digital-to-Analog Converter,数模转换器)成为模拟电信号,再驱动扬声器。反方向,模拟麦克风的电信号经 ADC(Analog-to-Digital Converter,模数转换器)成为数字样本,送入主机处理。A/D 和 D/A 的先后字母直接对应转换方向。
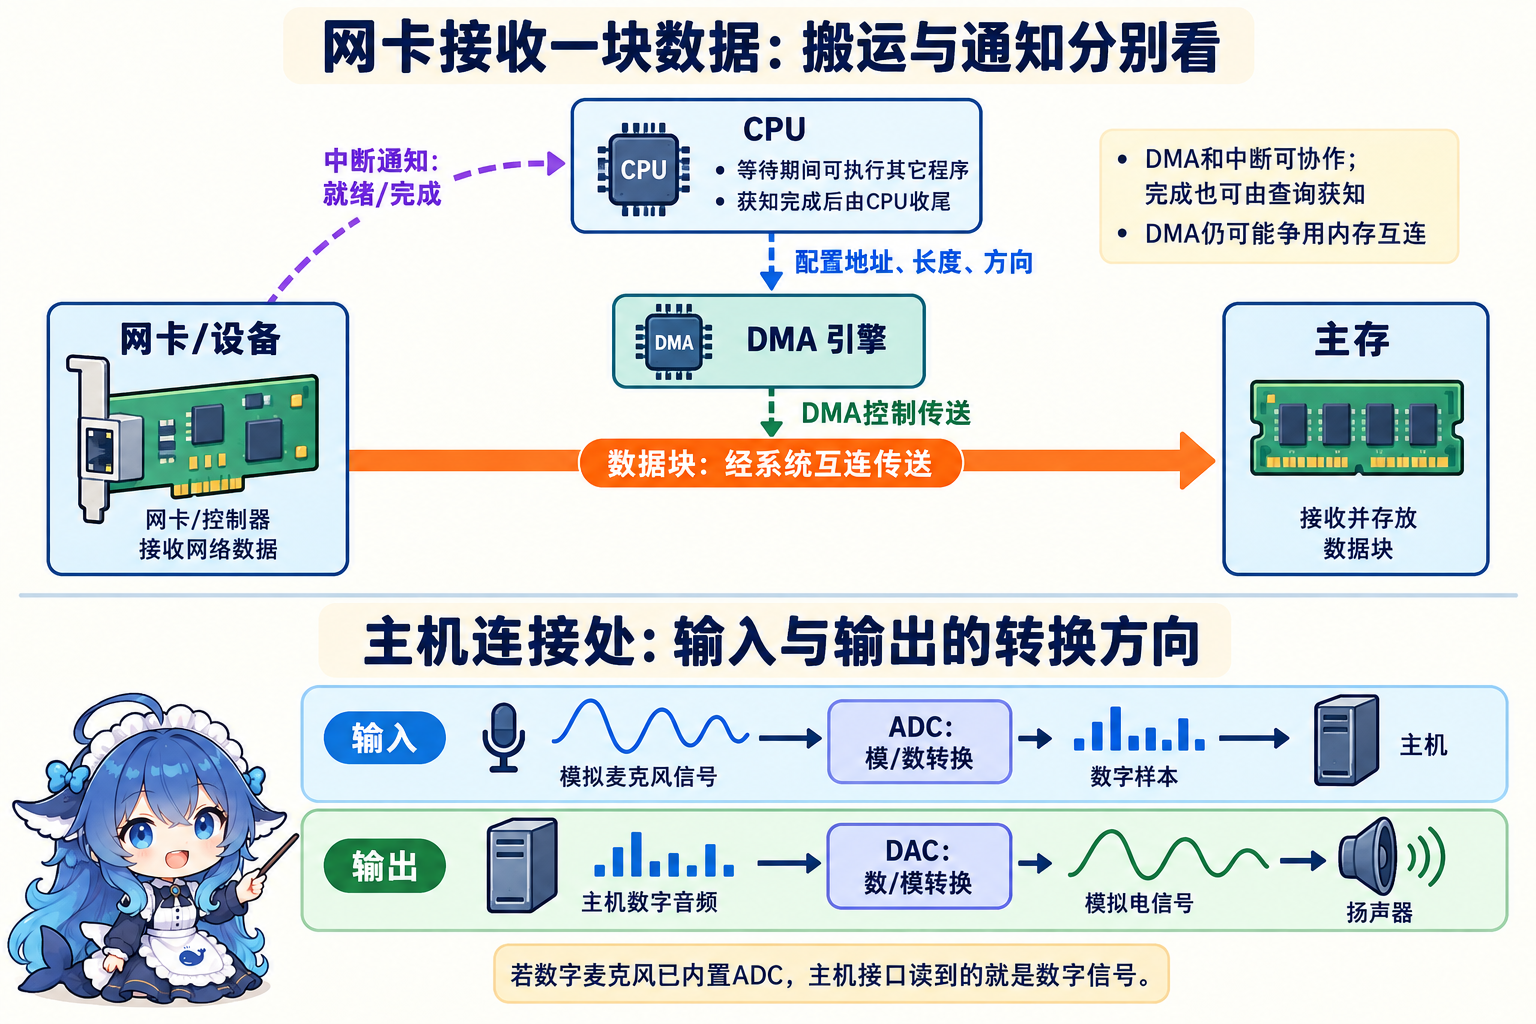

键盘可向主机送数字键码,打印机可从主机接数字命令;不需要仅因最终动作是按键或印纸,就在主机连接处添加 ADC/DAC。数字麦克风内部可能已有 ADC,主机直接读数字采样。采样、量化、编码和数据量在 2.7 多媒体继续展开。
外设范围还包括鼠标、扫描仪、摄像头、网卡、存储设备,以及移动设备的加速计/GPS/陀螺仪/感光和指纹部件、工业控制的测量与驱动装置。它们通过相应接口提供指令、数据和状态,种类没有规定单一转换方式。教材称外设为“非必要设备”,说的是具体设备可以按用途选配:没有键盘或显示器的服务器仍可经网络处理请求,传感节点也可经专用接口输入、输出。不能据此推断所有 I/O 连接都可整体删除。
回到预约服务,处理器执行控制与计算,存储系统提供信息,互连和接口安排传送;提高主频能改变部分 CPU 时间,要判断整次操作,还须检查缓存、I/O、网络和软件等待的条件。